Rayfinとは?
Rayfinとは、Microsoftが提供する、TypeScriptで宣言したデータモデルからMicrosoft Fabric上に業務アプリケーションのバックエンドを構築できる開発ツールです。npmパッケージとして配布され、TypeScript SDKとCLI(rayfinコマンド)で構成されます。
業務アプリケーションを1本作ろうとすると、ユーザーが操作する画面のほかに、データを格納するデータベース、その読み書きを担うAPI、ログインを管理する認証基盤、そしてレコード単位で誰に何を許可するかを決めるアクセス制御が必要になります。これらを個別に組み上げると、モデルの1項目を変更しただけでも、SQLスキーマ、API定義、クライアント側の型、権限ルールを別々に手直しする作業が発生します。
Rayfinはこの流れを、TypeScriptで書いた1つのデータモデル定義を起点に整理する設計です。エンティティのクラスにデコレーターで項目やアクセス制御を宣言すると、その内容からSQL database in Fabricのテーブル、API構成、そしてクライアント側で参照するTypeScript型がまとめて管理されます。定義を変えれば、複数のバックエンド要素へ同じ変更が反映されるため、モデルを1箇所で保つコードファーストの開発スタイルを実現できます。
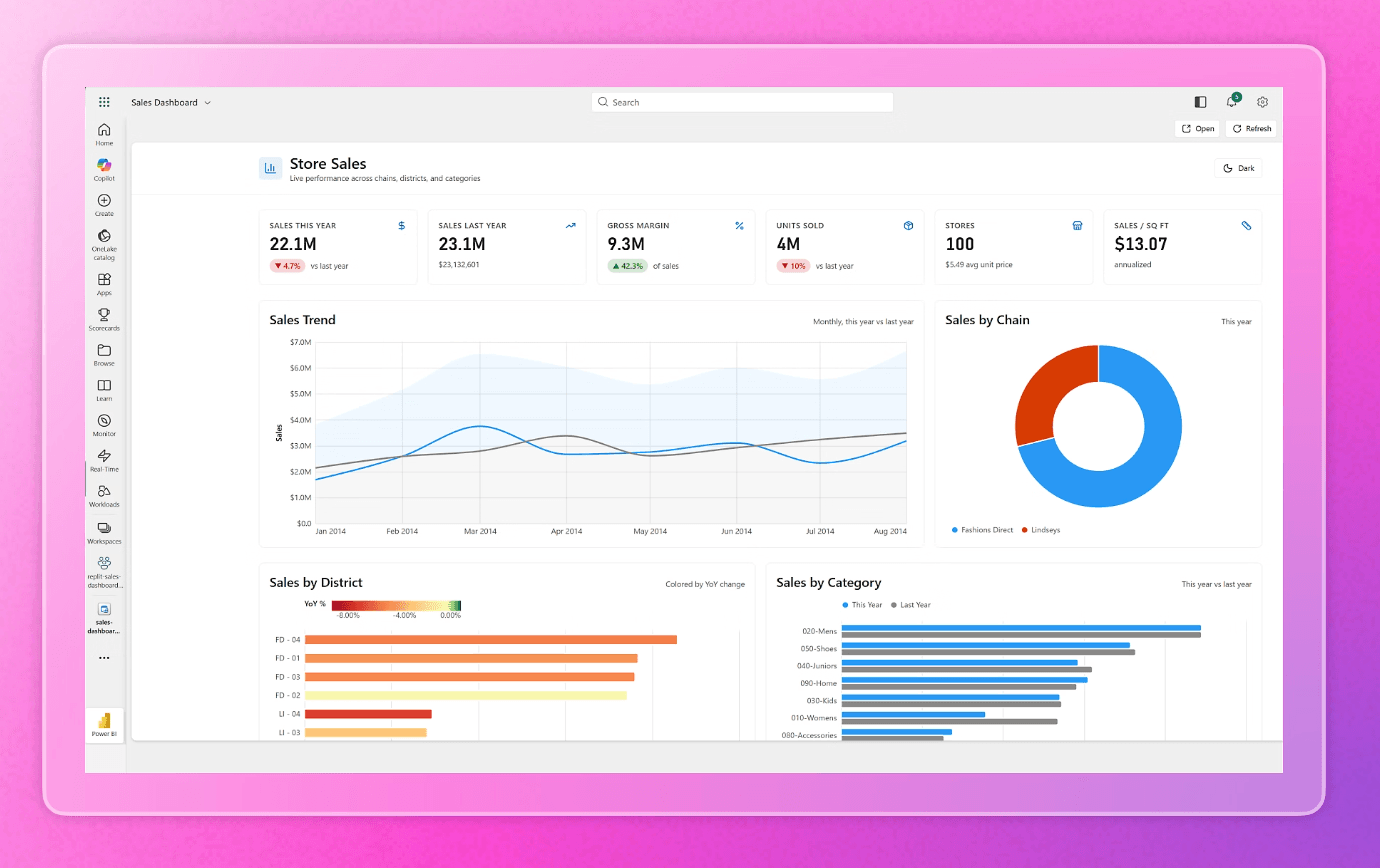
Rayfinで構築したFabric appの画面例 引用:Microsoft Fabric
RayfinとFabric Appsの関係
Rayfinで構築したアプリケーションは、Fabric AppsというMicrosoft Fabricの新しいワークロード上で動作します。RayfinはあくまでFabric Appsを扱うための開発ツールであり、実行環境自体はFabric Appsが提供します。
実装の役割分担を、以下の表で整理しました。
要素 | 役割 |
|---|---|
Rayfin SDK / CLI | TypeScriptのエンティティ定義を解析し、データベーススキーマ、アクセス権限、API構成を生成してFabricへ反映する開発ツール |
Fabric Apps | SQL database、認証、静的コンテンツ配信など、アプリのバックエンドが動くための実行環境をMicrosoft Fabric上に提供するワークロード |
RayfinClient | Fabric Appsが公開するGraphQLエンドポイントへ型付きでアクセスするための、フロントエンド側のクライアントライブラリ |
SQL分析エンドポイント | SQL database in Fabricに標準で付随するFabricの機能。Rayfin固有の生成物ではない |
OneLakeへの自動ミラーリング | SQL database in Fabricに標準で備わるFabric側の機能。Rayfin独自の機能ではない |
RayfinClientはFabric側へ配置されるサービスではなく、フロントエンド側のnpmパッケージです。Rayfinのデプロイと、そのアプリを利用するクライアント側の実装は、別のレイヤーとして分けて考える必要があります。
概念上のサービス構成
Microsoft公式ドキュメントでは、Fabric appの内部構造を以下のように示しています。
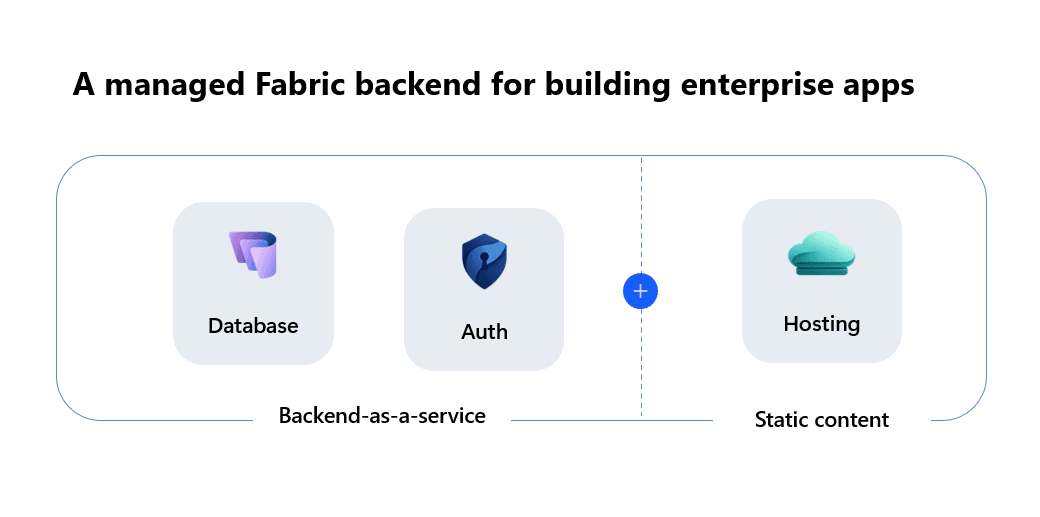
Fabric appのマネージドサービス構成 引用:What is Fabric Apps (Preview)?
この図が示すのは、Fabric appがデータベース、認証、静的コンテンツ配信をひとつのマネージドサービスとしてまとめているという概念構成です。実際にFabricポータルのワークスペース一覧で子アイテムとして表示されるものとは粒度が異なる点に注意してください(実機の表示は後述の利用手順で確認します)。
GraphQLエンドポイントの位置づけ
Fabric Appsが公開するGraphQLエンドポイントは、Fabric app内部のバックエンドURL(/api/graphql)として稼働します。Fabricポータル上に独立した「API for GraphQL」子アイテムとして表示されるわけではなく、RayfinClientやHTTPクライアントから利用する前提のエンドポイントです。
Rayfinの主な特徴
Rayfinの中心的な価値は、TypeScriptで書く1つのデータモデル定義を、バックエンドの複数要素に一貫して反映できる点にあります。ここではその設計を3つに整理してご説明します。
TypeScriptの定義からデータベースとAPIを構成
エンティティクラスに@entity()と各フィールドのデコレーターを付けると、rayfin up db applyによってその内容からテーブル、カラム、制約、およびAPI構成がFabric上に反映されます。従来はSQLマイグレーションとAPIコントローラーを別々に管理する必要があった作業を、モデル定義の編集にまとめられる点が特徴です。
RayfinClientによる型付きデータアクセス
RayfinClient<AppSchema>にプロジェクトのスキーマ型を渡すと、エンティティ名、フィールド名、入力値がすべてTypeScriptの型として検査されます。存在しないフィールドをselect()やcreate()に渡した場合、実行前にビルド時の型エラーとして検出されます。RayfinClient自体はフロントエンドから利用するnpmパッケージであり、Fabric側へデプロイされるサービスではありません。
データモデルとアクセス権限をコードで管理
@role()デコレーターを併記すると、ロールと条件式によるアクセス制御ルールがモデル定義と同じファイルで扱えます。データ構造とアクセスルールを同じプロジェクト内で管理できるため、モデル変更時に権限設定の更新が漏れにくくなる、というのが公式仕様上の設計です(本記事の実機デモではアクセス制御の動作までは検証していません)。
なお、Rayfin CLIのrayfin up db applyは、内部的にData API builder(DAB)の構成を生成して適用する仕組みだと公式CLIリファレンスに明記されています。DABはMicrosoftのOSSで、データベースからREST・GraphQLエンドポイントを構成するための基盤として利用されています。
Rayfinの料金
ここでは、Rayfinを利用する際に発生する費用の考え方をご説明します。
Rayfin SDKおよびCLIはMicrosoftからnpmパッケージとして無償で公開されており、パッケージ自体のライセンス料金は設定されていません。一方、Fabric Appsとしてアプリケーションを稼働させるには、Fabric容量が割り当てられたワークスペースが必要です。アプリケーションの処理は、割り当て先の容量ユニット(CU)を消費します。
容量を消費する対象
Fabric appが容量を消費するのは、SQL Database、GraphQL API、そして静的コンテンツを保持・配信するOneLakeストレージです。以下の表で、それぞれの課金対象と公式の課金メーター名を整理しました。
サービス | 課金対象となる操作 | 課金メーター | 種別 |
|---|---|---|---|
SQL Database(計算) | GraphQL APIおよびポータルのクエリエディターから発行されるSQLクエリ、更新、データ処理 | SQL database in Fabric Capacity Usage CU | Interactive |
SQL Database(ストレージ) | テーブル、インデックス、トランザクションログ、メタデータのための動的なストレージ | SQL Storage Data Stored | Background |
GraphQL API | RayfinClientがデータモデルに対して実行する読み取りクエリと書き込みミューテーション | API for GraphQL Query Capacity Usage CU | Interactive |
Static Content(OneLake Read) | 静的コンテンツをエンドユーザーへ配信する際の読み取り操作 | OneLake Read Operations Capacity Usage CU | Background |
Static Content(OneLake Write) |
などによる静的コンテンツの配置・更新時の書き込み操作 | OneLake Write Operations Capacity Usage CU | Background |
Static Content(OneLake Storage) | 静的コンテンツファイルの格納容量 | OneLake Storage | Background |
OneLake関連のメーターは、Rayfin appの静的コンテンツホスティング(Static Content)に対する課金です。SQL databaseからOneLakeへの自動ミラーリングはFabric側の標準機能で、そちらに紐づく課金ではありません。
Interactive と Background の区別は、実務ではサイジングを考えるうえで押さえておく必要があります。Interactiveに分類される操作は利用者の待ち時間に直結するため、ピーク時の容量が不足すると体感速度に影響します。GraphQL APIはリクエストとレスポンスの処理時間1時間あたり10 CUの割合で計測され、Fabric CU 1つはSQL databaseの0.383 vCoresに相当する、という換算基準が公式に示されています。
検証時の進め方
小規模なF SKUで検証を開始し、Microsoft Fabric Capacity Metricsアプリでアイテム別・操作別の消費量を計測したうえで容量をスケールする進め方が現実的です。上記の内容は2026年8月時点の情報です。Fabric容量の単価はリージョンおよび契約形態(従量課金・予約)によって異なるため、最新のレートはMicrosoft Fabric公式料金表、Rayfinの課金メーター詳細はPricing and capacity usage for Fabric Appsをご覧ください。
Rayfinの利用手順
ここでは、TypeScriptでモデルを定義し、Microsoft Fabricへデプロイして、生成物を確認するまでの基本操作を順にご説明します。題材は社内の備品情報を扱う小規模アプリケーションで、Assetエンティティを1つ定義するところから始めます。
1. 開発環境と前提条件を確認する
Rayfinを利用するには、以下の4点を満たしている必要があります。
- Fabric容量が割り当てられたワークスペース:RayfinアプリはワークスペースのFabric容量(CU)を消費して動作します。デプロイやスキーマ変更を行うには、対象ワークスペースへの書き込み権限が必要です
- Fabric Appsワークロードの有効化:テナント管理者がFabric管理ポータルから有効化する必要があります。組織全体に開放するか、特定のセキュリティグループに限定するかを選択できます
- 対応リージョンの確認:Fabric Appsはすべてのリージョンで利用できるわけではありません。日本国内ではJapan Eastが対応しており、Japan Westは対応していません
- Node.jsとnpmのインストール:ローカル環境に用意します。CLIは
npm i @microsoft/rayfin-cliで個別に導入することもできます
2. Rayfinプロジェクトを作成する
公式テンプレートからプロジェクトを生成します。<workspace name>にはデプロイ先のFabricワークスペース名を指定します。
npm create @microsoft/rayfin@latest my-app --workspace <workspace name>
cd my-app
生成されるプロジェクトでは、フロントエンドをsrc/に、データモデルをrayfin/data/に置きます。アプリ設定はrayfin/rayfin.yml、環境変数はrayfin/.envで管理します。既存のフロントエンドコードに追加する場合や、テンプレートを一覧して選択する場合はrayfin initを使います。
3. 最初のAssetエンティティを定義する
rayfin/data/Asset.tsに、備品管理の対象となるAssetエンティティを1つ定義します。すべてのエンティティはidという名前のUUIDを主キーとして持ちます。
import { entity, uuid, text, date, role } from "@microsoft/rayfin-core";

@entity()
@role("authenticated", "*", {
  policy: (claims, item) => claims.sub.eq(item.ownerId),
})
export class Asset {
  @uuid() id!: string;
  @text({ min: 1, max: 100 }) name!: string;
  @text({ max: 50 }) department!: string;
  @text() status!: string;
  @text() ownerId!: string;
  @date() createdAt!: Date;
}
@role("authenticated", "*", { policy: ... })は、サインインしているユーザーの識別子(claims.sub)とレコードの所有者(item.ownerId)が一致する場合に操作を許可する、というルールを表す宣言です。このアクセス制御の実挙動は本記事のデモ範囲では検証範囲外のため、公式仕様に沿った書き方として捉えてください。
定義したエンティティは、スキーマファイルへ登録します。
import { Asset } from './Asset.js';

export type AssetAppSchema = {
  Asset: Asset;
};

export const schema = [Asset];
この2ファイルが、データベースのテーブル、GraphQL API、クライアント側の型の共通の設計情報になります。
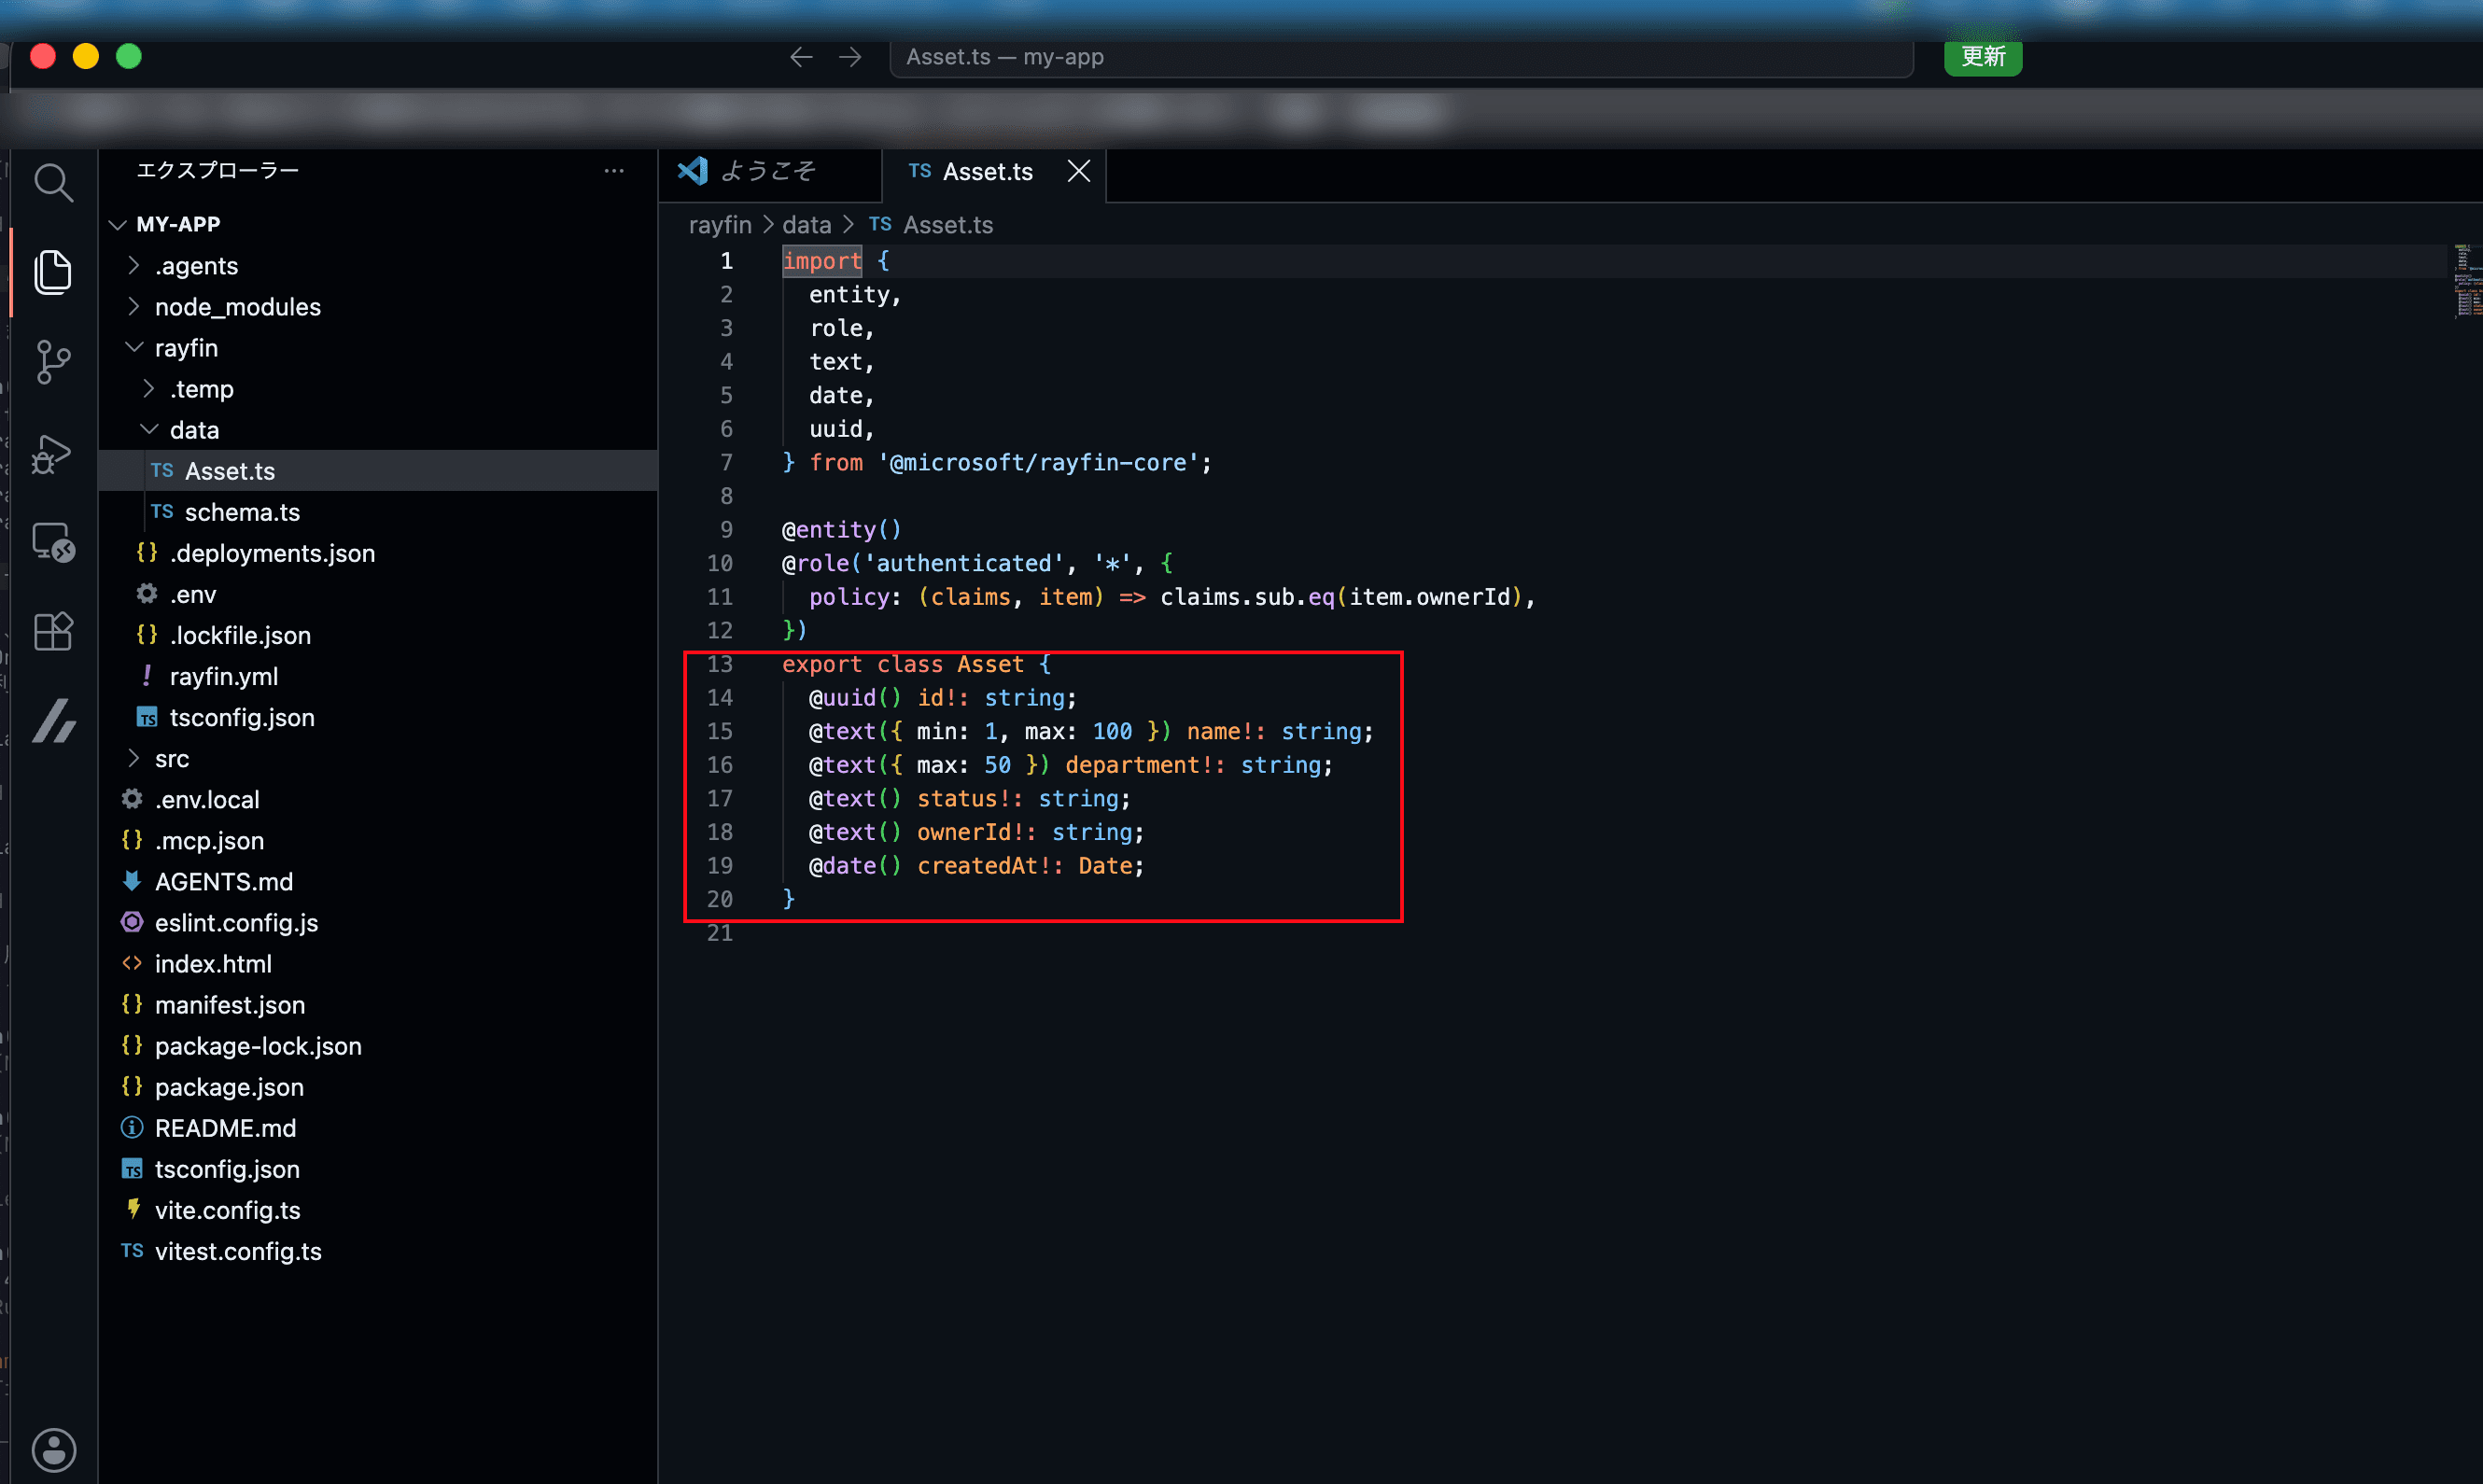
Asset.tsをVS Codeで編集した状態
4. npx rayfin upでFabricへデプロイする
エンティティの定義が済んだら、Fabricへデプロイします。
npx rayfin up実行内容を事前に確認したい場合は、--dry-runを付けると変更を加えずに予定されるアクションを表示できます。ワークスペースを明示して非対話的に実行することもでき、CIから呼び出す場合はこの形になります。
npx rayfin up --workspace-id 00000000-0000-0000-0000-000000000000 --yes
初回のデプロイは通常2〜5分ほどかかります。以降、静的コンテンツのみを更新するnpx rayfin up staticapp deployは30〜60秒で完了する、と示されています。
5. Fabric appとSQL databaseが作成されたことを確認する
Fabricポータルを開き、対象ワークスペースにRayfinアイテム(Fabric app)が作成されていることを確認します。RayfinのデプロイによってAsset用のSQL databaseがFabric上に作成され、それに標準で付随するFabricのSQL分析エンドポイントも同時に生成されます。これらはFabric appの子アイテムとしてまとめて表示されます。
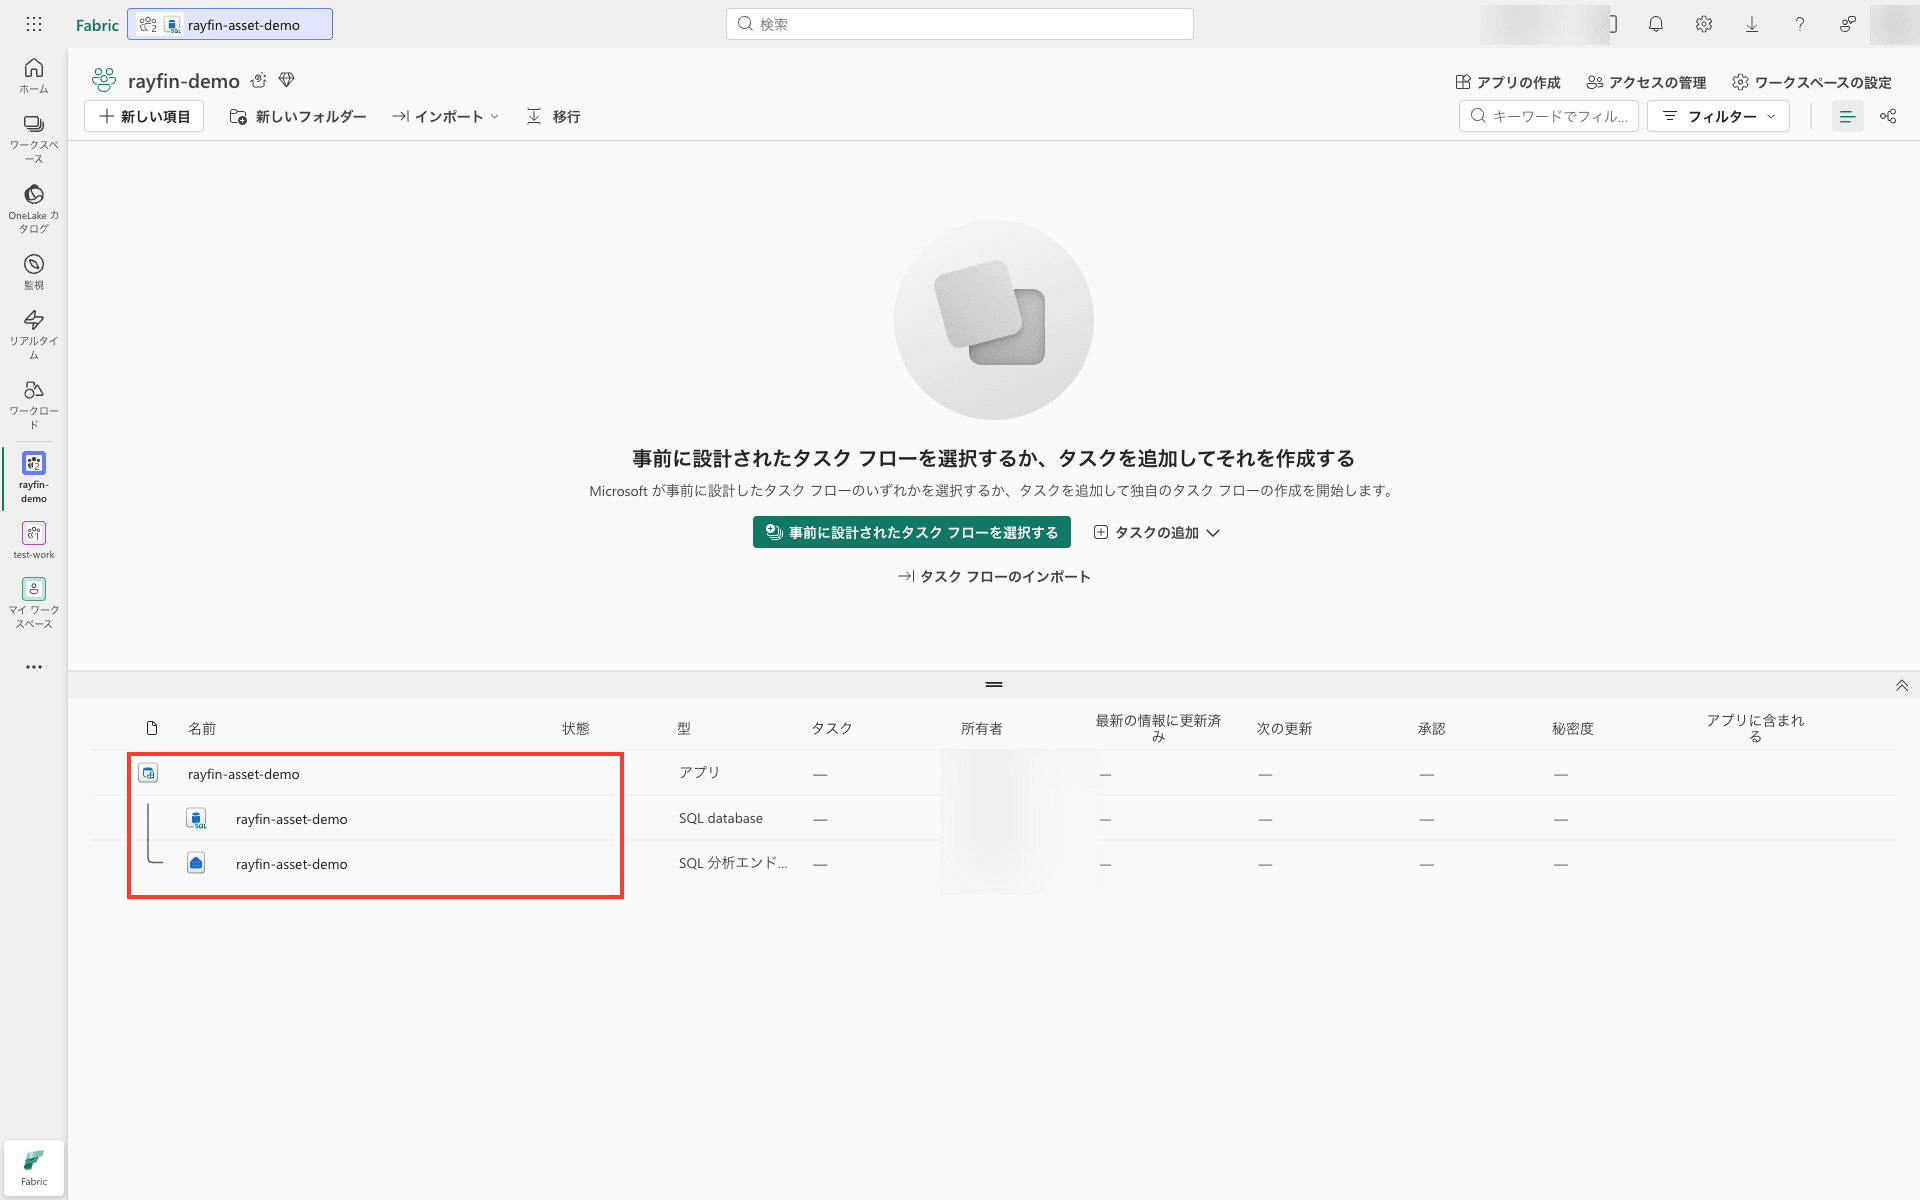
ワークスペースに並ぶFabric app(Rayfinアプリ本体)、SQL database、SQL分析エンドポイント
Fabric appは概念上のマネージドサービス構成として、データベース、認証、静的コンテンツ配信の3つを内包しますが、ワークスペースの一覧で子アイテムとして確認できるのは、Rayfinが作成したSQL databaseと、それにFabricの標準機能として付随するSQL分析エンドポイントです。認証と静的コンテンツ配信は、Fabric app内部の設定・機能として扱われます。
続いて、SQL database in Fabricのクエリエディターを開き、生成されているテーブルをINFORMATION_SCHEMA.TABLESで確認します。
SELECT TABLE_SCHEMA + '.' + TABLE_NAME AS full_name, TABLE_TYPE
FROM INFORMATION_SCHEMA.TABLES
WHERE TABLE_SCHEMA NOT IN ('sys','INFORMATION_SCHEMA');
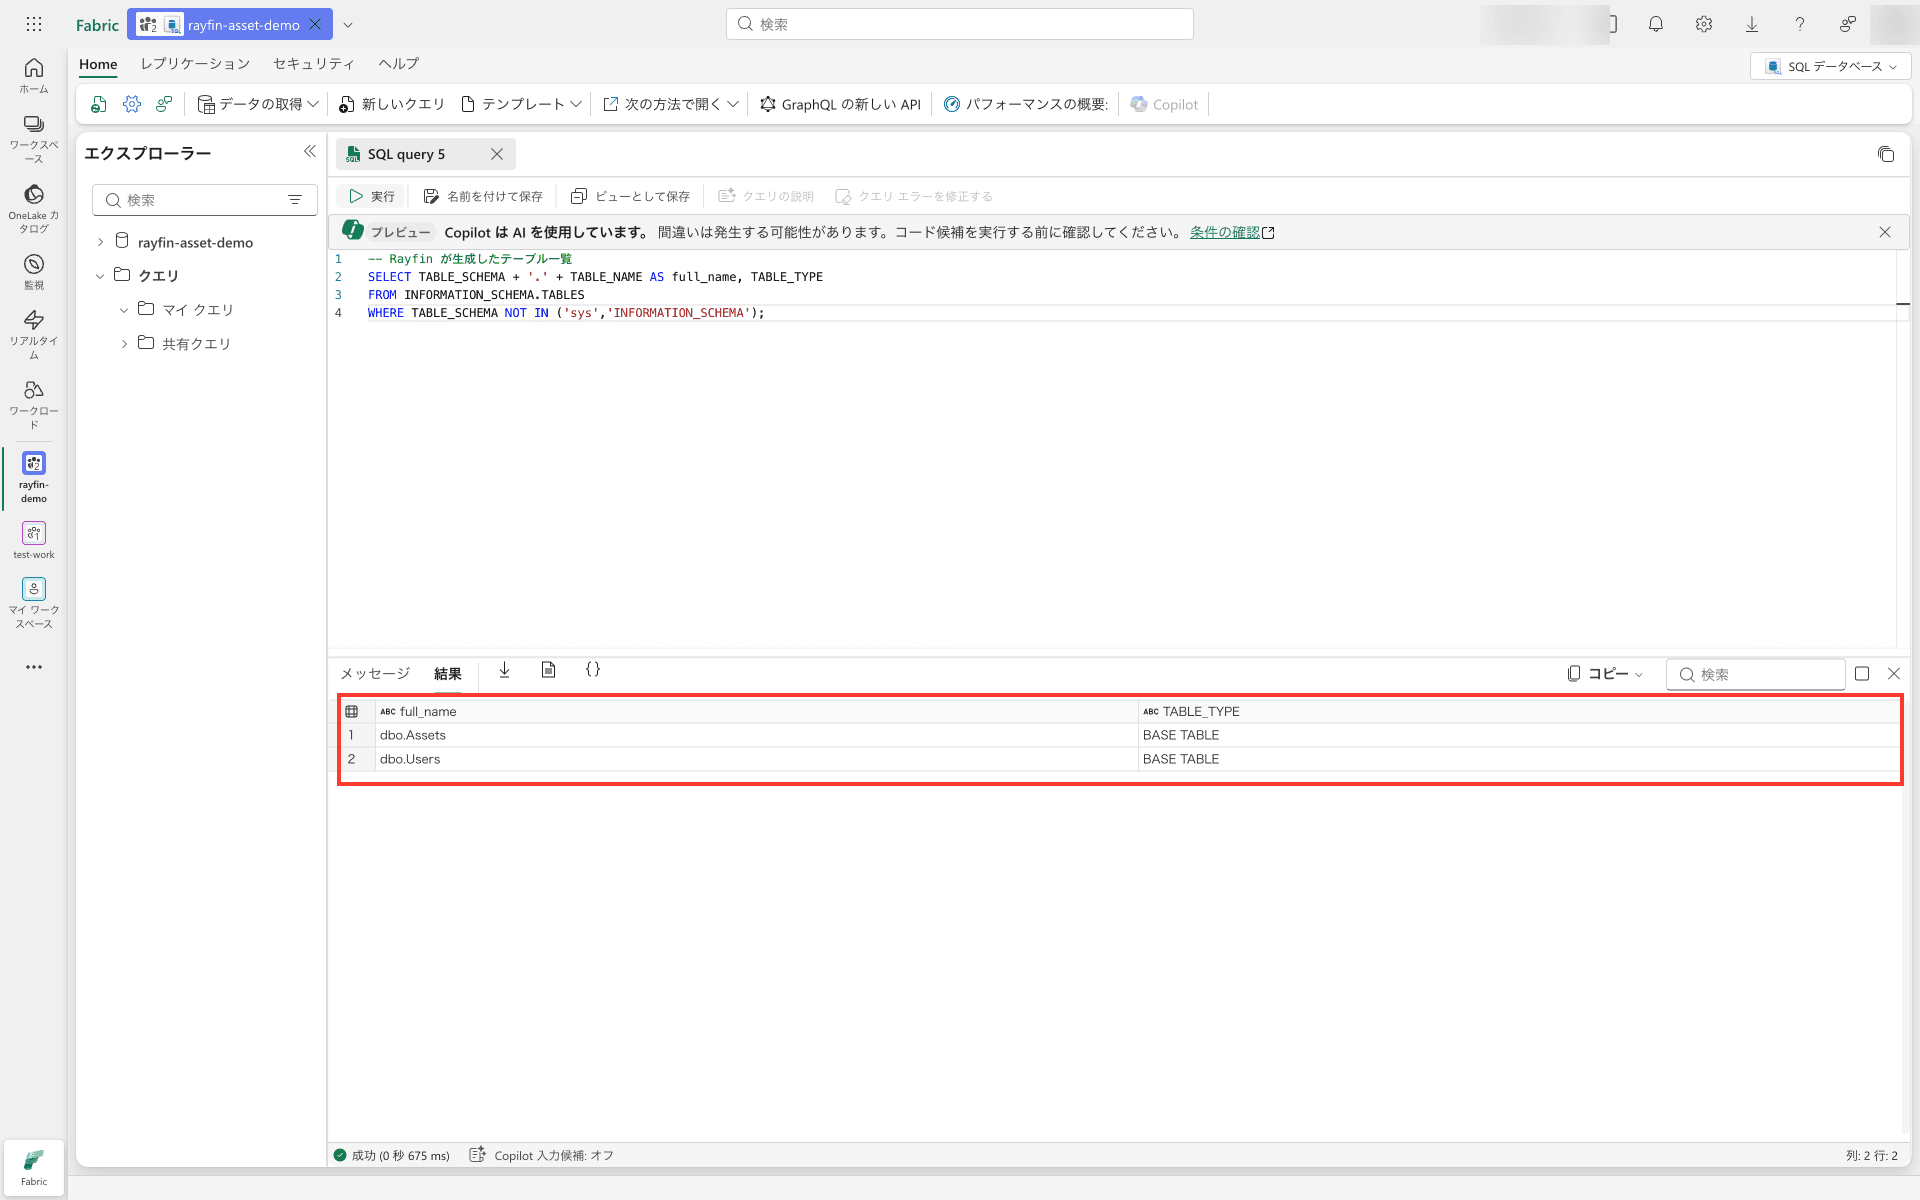
デプロイ後にSQL database in Fabricで確認できるテーブル一覧
dbo.Assetsとdbo.Usersの2つが表示されます。dbo.Assetsは先ほど定義したAssetエンティティに対応するテーブルで、クラス名が複数形化された形(Asset → Assets)で生成されています。また、dbo.Usersも生成されていることを確認しました。
※本検証では、dbo.Usersの用途、内容、ユーザー登録のタイミングまでは確認していません。
次に、Assetsテーブルのカラム定義を確認します。
SELECT COLUMN_NAME, DATA_TYPE, CHARACTER_MAXIMUM_LENGTH AS MAX_LEN, IS_NULLABLE
FROM INFORMATION_SCHEMA.COLUMNS
WHERE TABLE_SCHEMA = 'dbo' AND TABLE_NAME = 'Assets'
ORDER BY ORDINAL_POSITION;
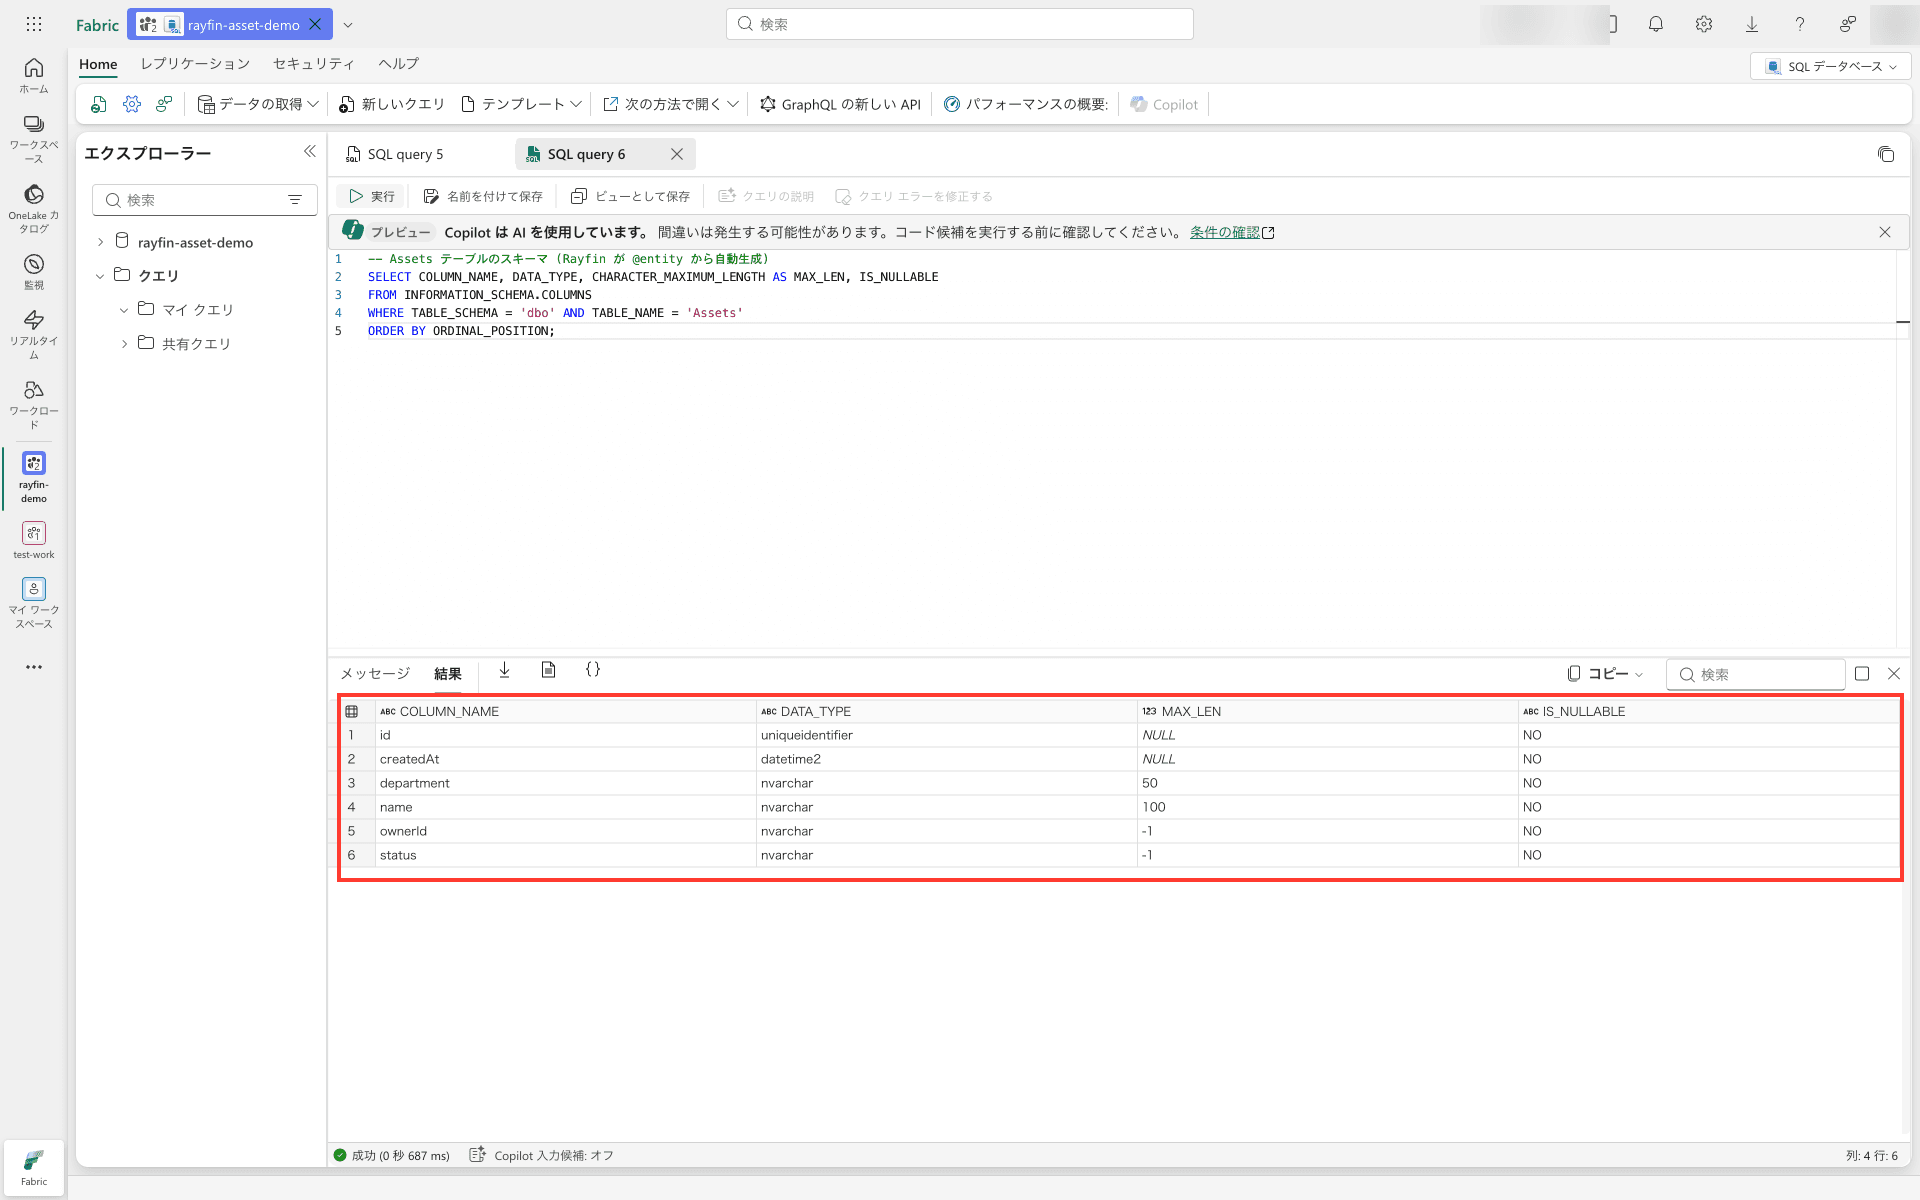
Asset.tsのデコレーターがSQLカラムの型と最大長にそのまま反映されている
TypeScript側のデコレーターとSQL側の型が、以下のように厳密に対応しています。
TypeScript定義 | SQLカラム | データ型 | 最大長 |
|---|---|---|---|
| id | uniqueidentifier | — |
| createdAt | datetime2 | — |
| department | nvarchar | 50 |
| name | nvarchar | 100 |
| ownerId | nvarchar | MAX (-1) |
| status | nvarchar | MAX (-1) |
@text({ max: 50 })がnvarchar(50)に、@text({ max: 100 })がnvarchar(100)にそのまま反映されている点が、Rayfinの型付きな定義がSQLスキーマへ変換される様子を端的に示しています。ここまでで、TypeScript側の宣言から Fabric上に SQL database が作成されるまでの基本操作は完了です。
Rayfinの活用デモ:データモデルの変更をバックエンドへ反映する
ここまでで、TypeScriptの宣言から Fabric上にSQLテーブルが作成されるところまでを確認しました。このセクションでは、その一歩先として、Rayfinの中心価値である「一つのデータモデル定義を編集するだけで、SQLスキーマとRayfinClient側の型が同じ変更に追従する」という挙動を、確認します。
デモの題材として、Assetエンティティに保管場所を表すlocationフィールドを追加します。既存のレコードが残っている場合を想定し、必須ではなくオプショナル項目として追加します。
1. 変更前のデータモデルとSQLスキーマを確認する
変更前のAsset.tsには、id, name, department, status, ownerId, createdAtの6フィールドしかなく、locationはまだ宣言されていません。SQL側のAssetsテーブルにも当然locationカラムはありません(上記「Rayfinの利用手順」Step 5の「Assetsテーブルのカラム定義」画像がそのまま変更前の状態を表しています)。
2. Asset.tsへlocationを追加する
Asset.tsに、以下の1行を追記します。既存レコードを壊さないため、optional: trueを付けてNULL許容のフィールドとして扱います。
@text({ max: 100, optional: true }) location?: string;
追加後のAsset.tsは以下のようになります。
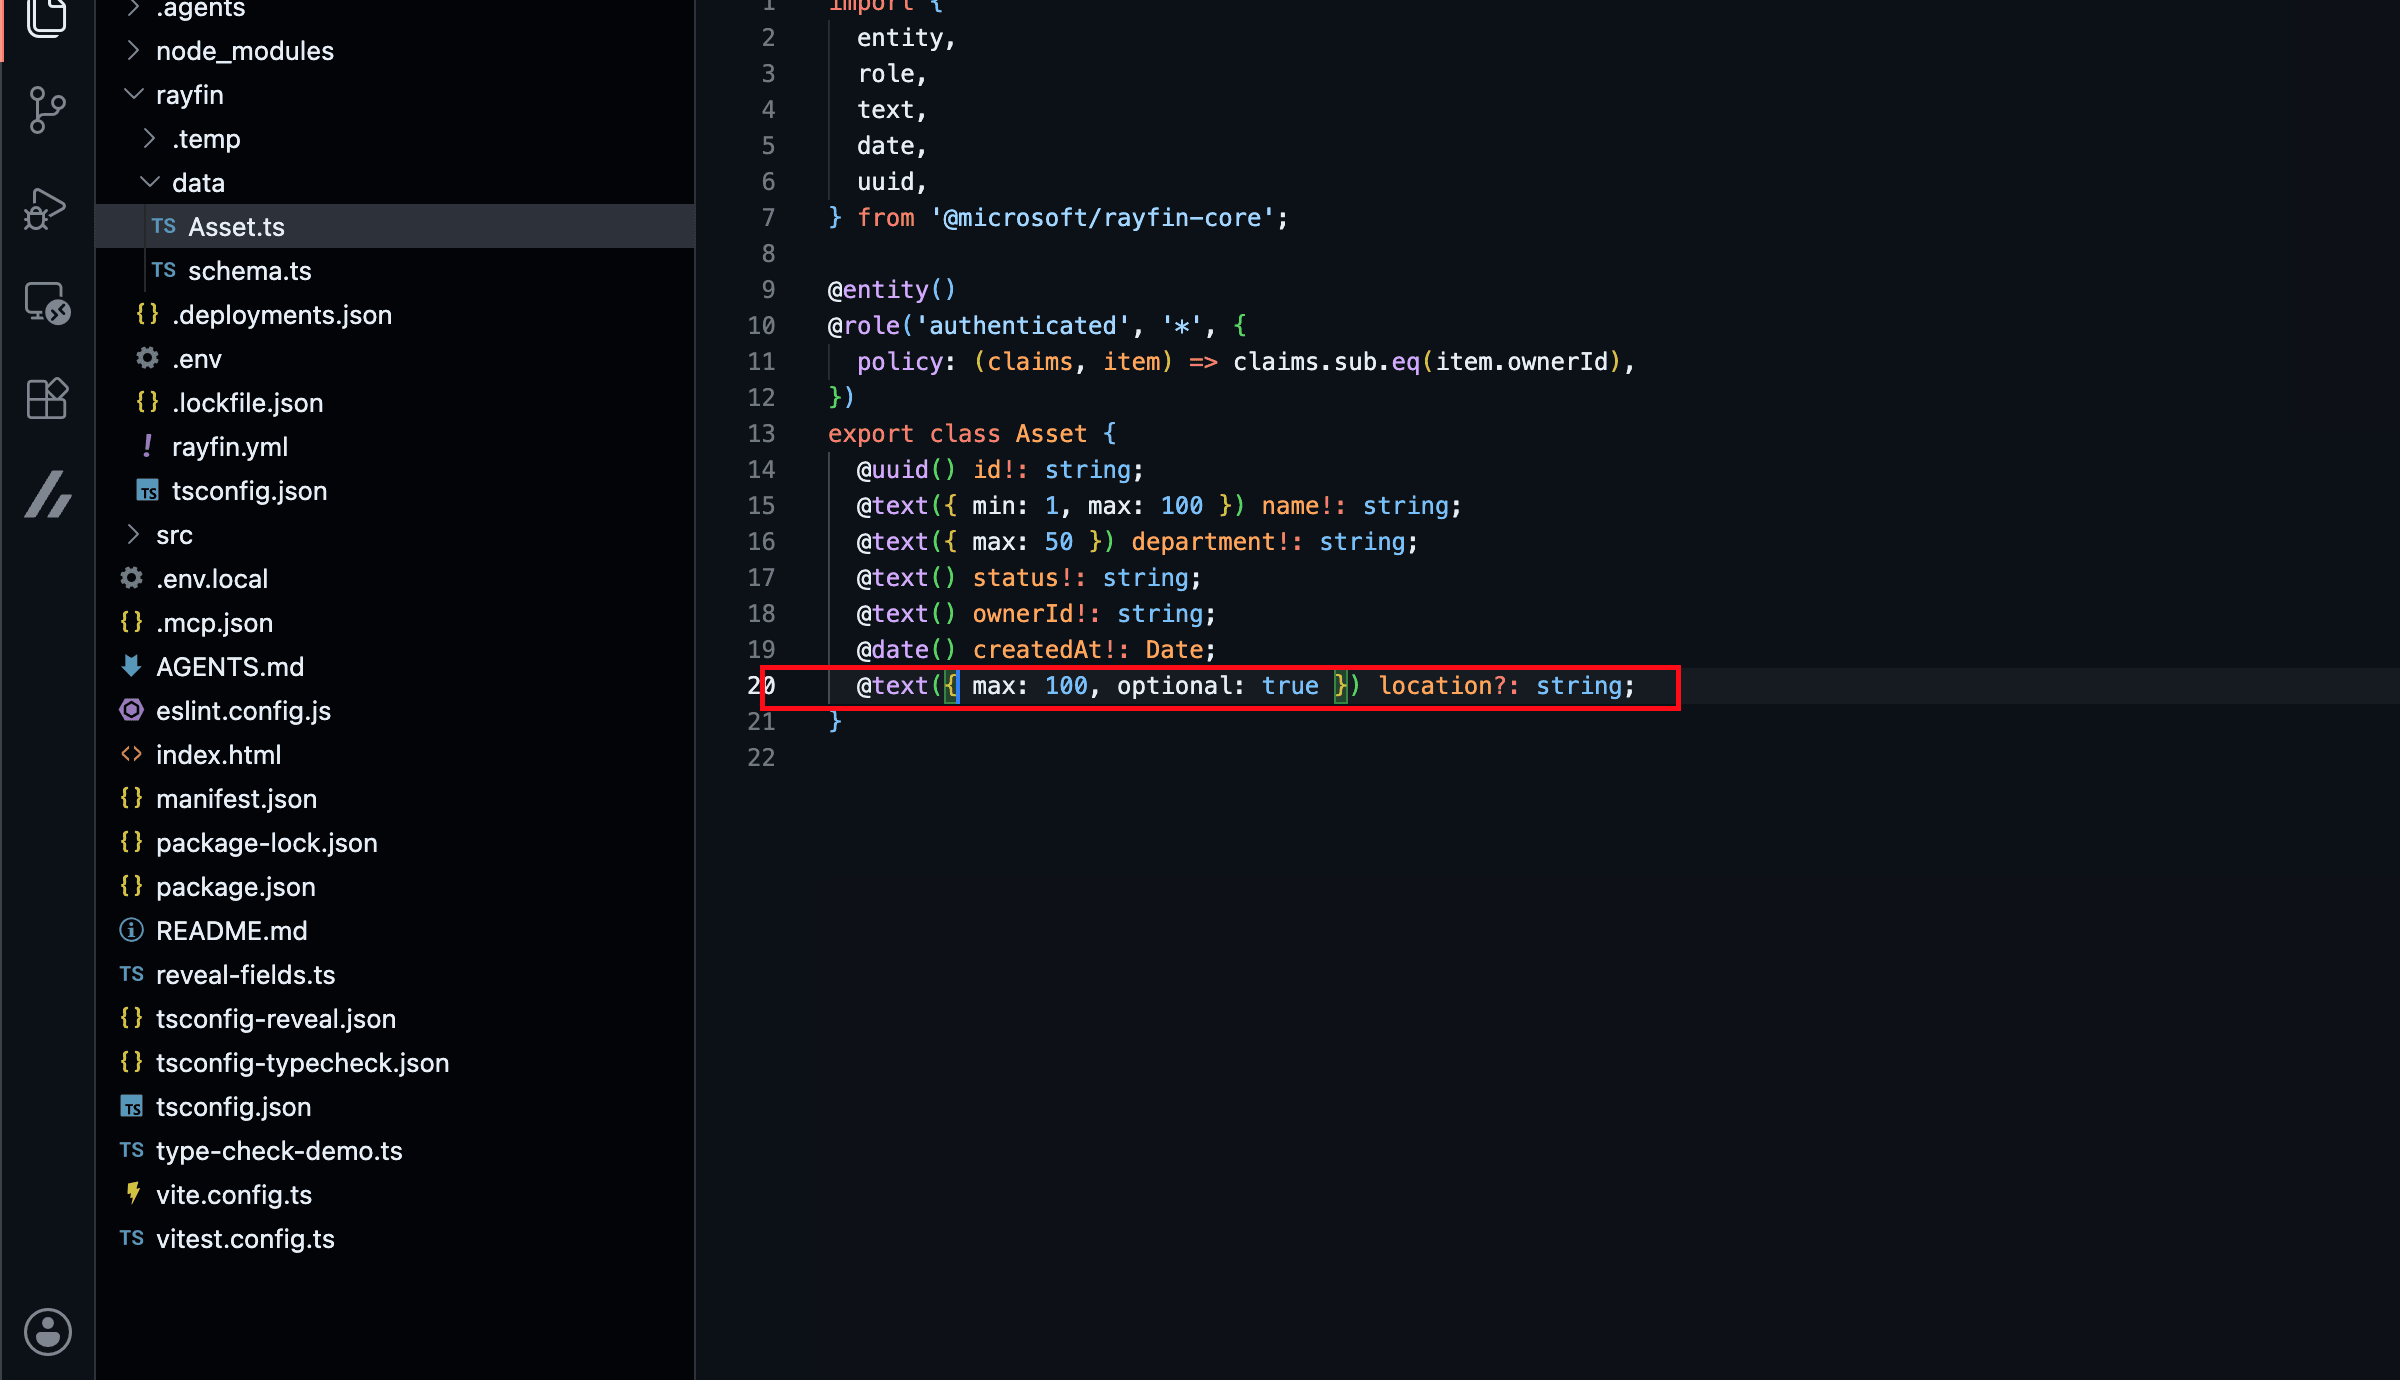
Asset.tsの末尾にlocationフィールドを追加
追記はこの1行です。この編集内容がSQLスキーマとRayfinClientの型の両方に反映される様子を、次の手順で確認します。
3. データベース変更をFabricへ反映する
CLIのrayfin up db applyを実行して、変更後のモデル定義をFabricのSQL databaseへ反映します。
npx rayfin up db apply実行結果は以下のとおりです。CLIがデコレーターを解析してlocationを「max:100, isOptional:true, format:text」として認識し、DAB configurationを生成してFabricへ適用しています。
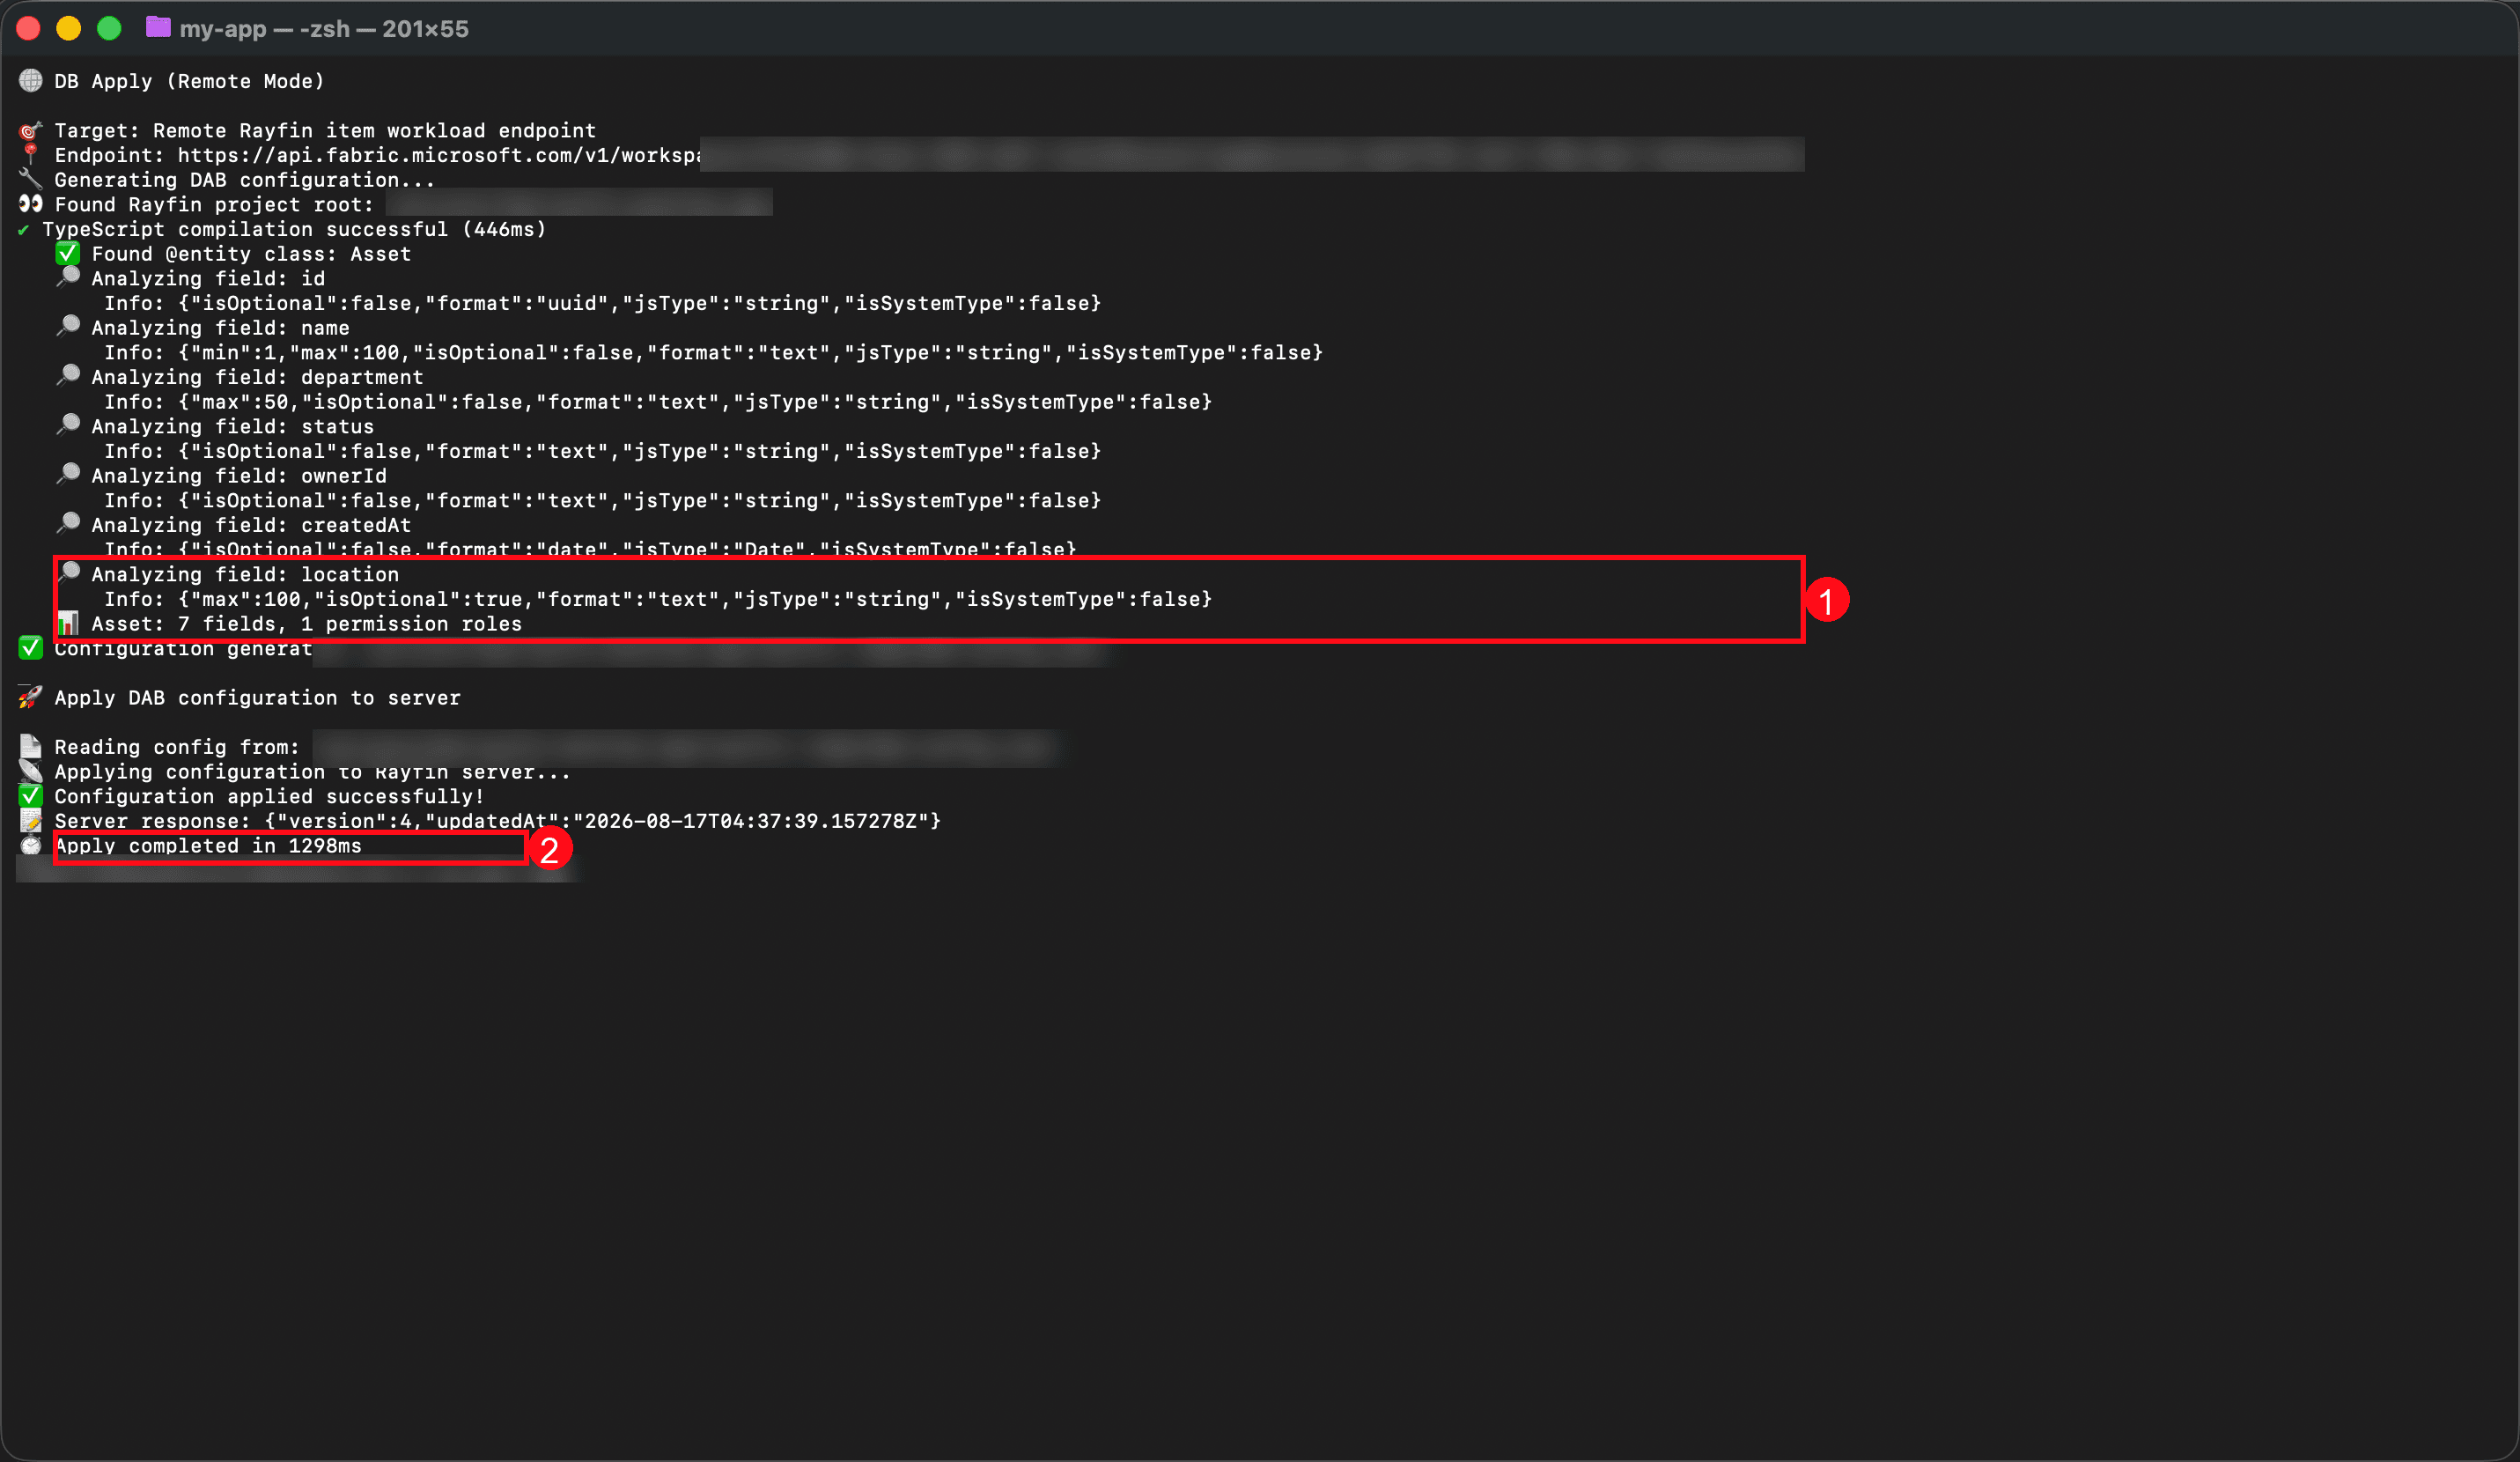
ターミナル上でのrayfin up db apply実行結果
赤枠①では、CLIがAssetエンティティの解析中に、追加したlocationフィールドを{max:100, isOptional:true, format:text}として検出したことが分かります。赤枠②では、生成されたDAB構成がFabric側のRayfinアイテムへ正常に反映されたことを示しています。
4. SQLスキーマへlocationが追加されたことを確認する
Fabricポータルの SQL database in Fabric のクエリエディターで、INFORMATION_SCHEMA.COLUMNSを再度実行し、変更後のAssetsテーブルのカラム定義を確認します。
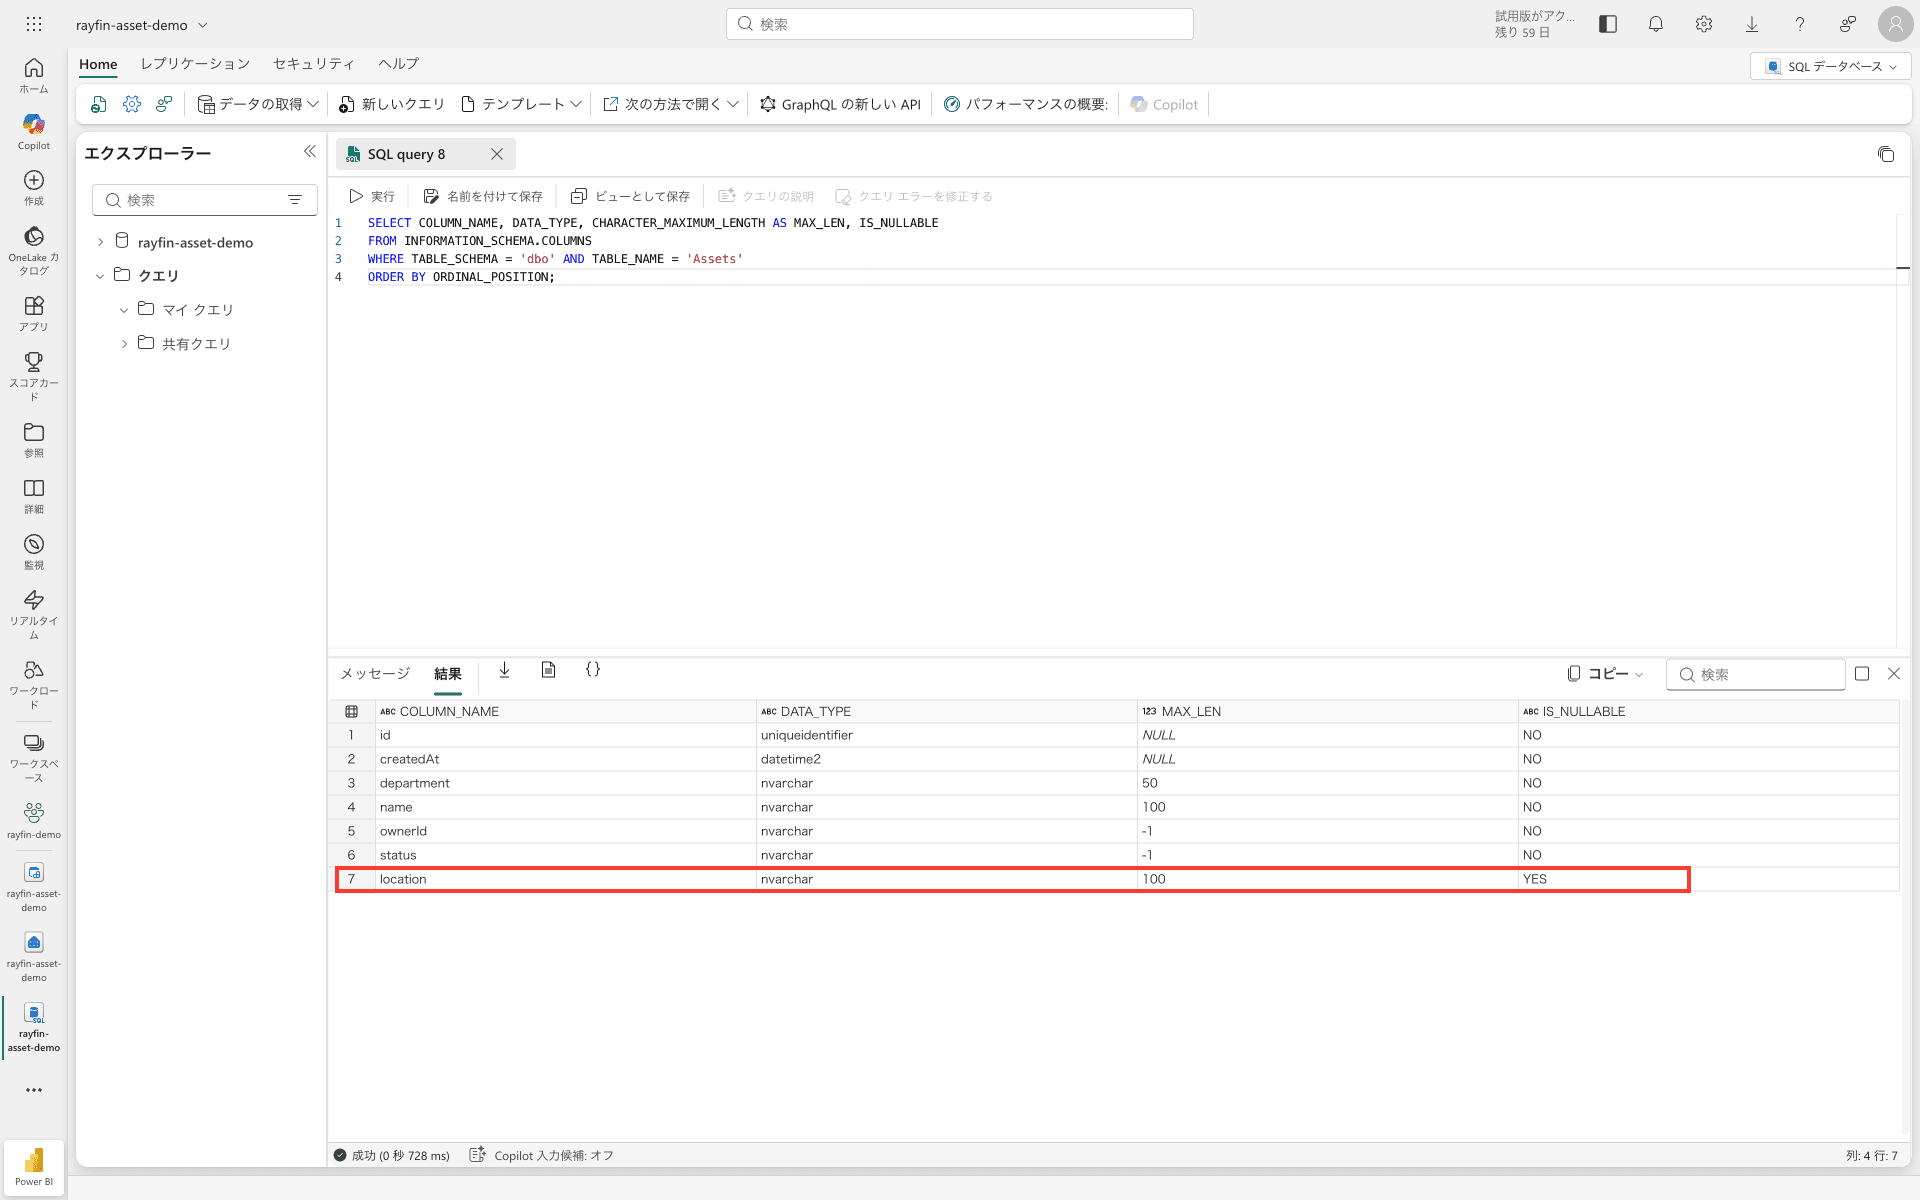
Assetsテーブルの7行目にlocationが追加されている
結果の7行目に、locationカラムがnvarchar(100)、IS_NULLABLE = YESとして追加されています。追記したデコレーター@text({ max: 100, optional: true })の内容が、SQL側の型・最大長・NULL可否にそのまま反映されていることが確認できます。
5. RayfinClientの型へlocationが反映されたことを確認する
同じ変更が、フロントエンド側で使うRayfinClientのTypeScript型にも反映されているかを確認します。プロジェクトのAssetAppSchemaを指定したRayfinClientからclient.data.Asset.select([...])を呼び出すコードを用意し、selectの引数配列に追加したばかりのlocationを含めた状態でtsc --noEmitを実行します。
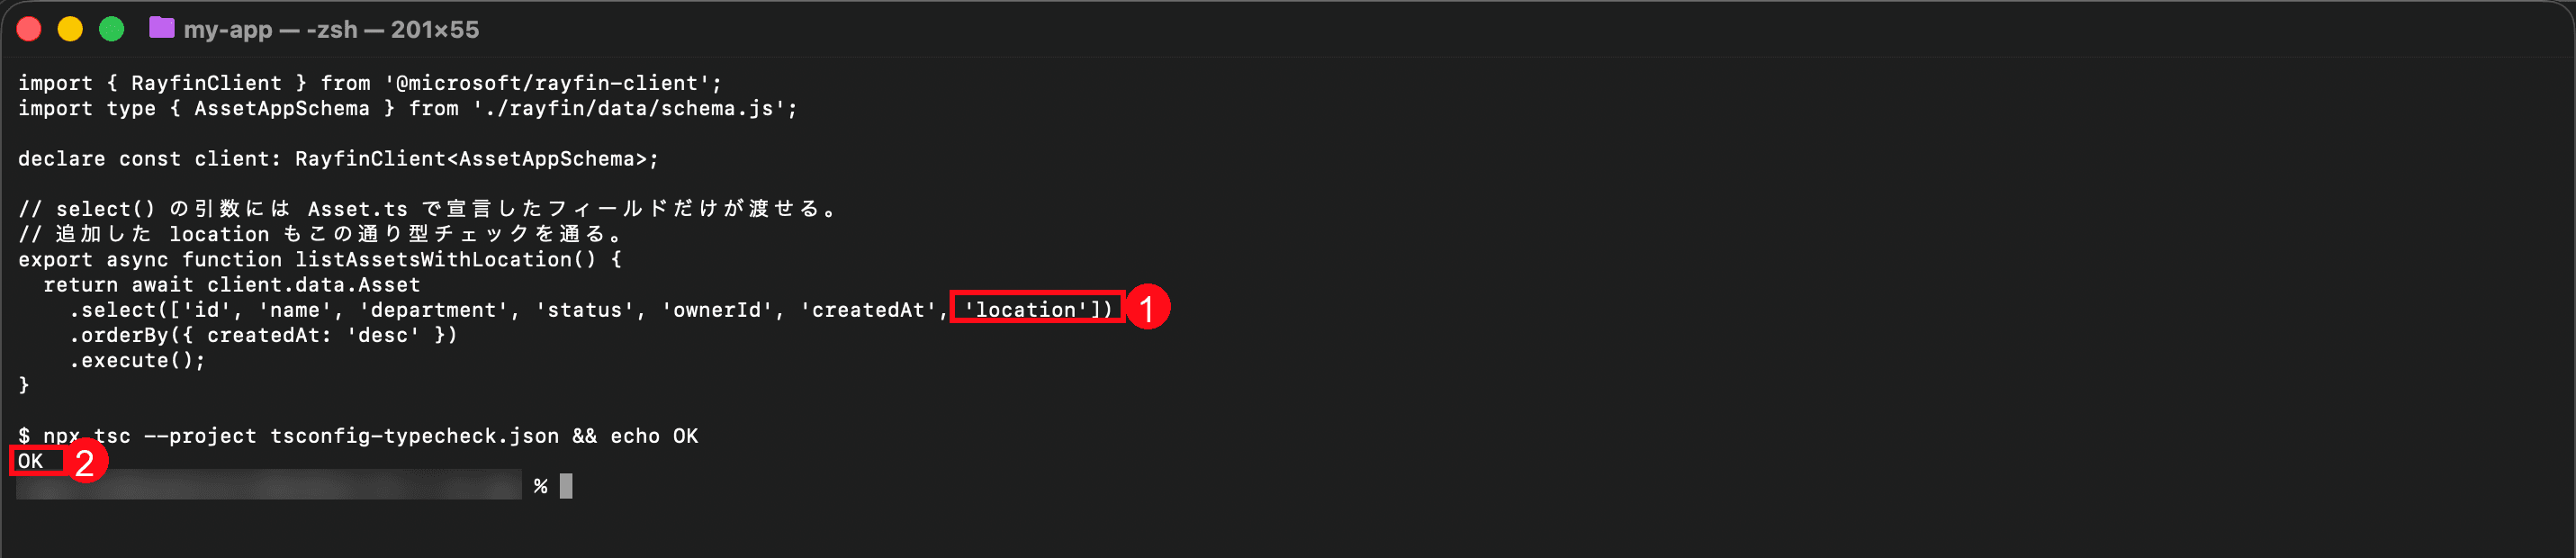
selectの引数配列にlocationを含めた状態でtsc --noEmitがエラー無く通り、型チェックに成功した状態
赤枠①はコード中で.select([...,'location'])と書いても型チェックが通ることを示し、赤枠②はそのtsc --noEmitが正常終了(OK)したことを示しています。AssetAppSchemaの中にlocationがフィールドとして認識されていない限り、この配列引数は型エラーになります。
念のため、逆方向のチェックとして、存在しないフィールド名notDefinedFieldをselectに混ぜてtscを再実行しました。
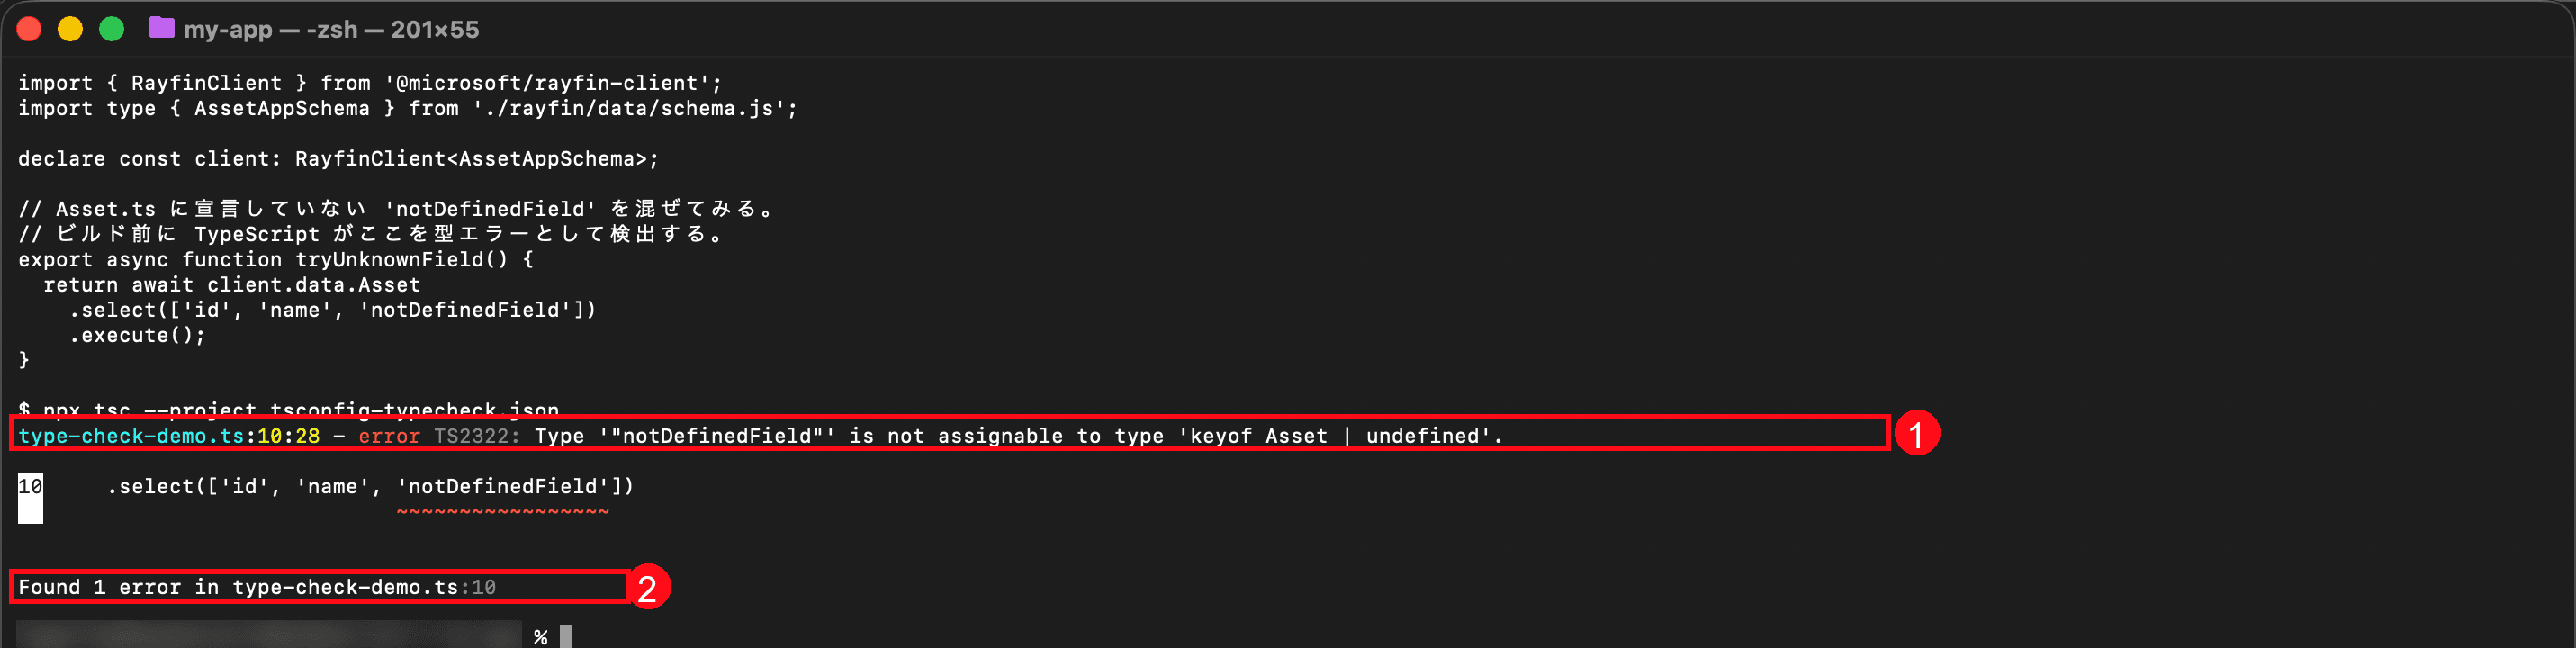
Asset.tsに宣言していないnotDefinedFieldは、実行前の型チェックで検出される
赤枠①のように、tscはType '"notDefinedField"' is not assignable to type 'keyof Asset | undefined'という型エラーを出し、赤枠②でFound 1 errorと報告しています。RayfinClient<AssetAppSchema>をTypeScriptで型チェックする構成では、未定義フィールドを実行前の型エラーとして検出できます。
デモで確認できたこと
このデモで実機として確認できた内容は、以下の4点です。
Asset.tsへ追加したlocationが、SQL側のnvarchar(100)カラムとして反映された- 同じ
locationが、RayfinClient側でselect可能なフィールドとして型チェックを通った - 未定義フィールドは、TypeScriptの型エラーとして実行前に検出された
- 一つのTypeScript定義を起点に、SQLスキーマとフロントエンド側の型を揃えられる、というRayfinの中心価値を実機で1周確認できた
Rayfinを実務で活かす運用のポイント
ここでは、Rayfinを継続的に開発・運用していくうえで押さえておきたい設計と運用のコツをご説明します。
サブコマンドで変更範囲を絞る
開発が進むと、変更の範囲は限定的になります。Rayfin CLIには、対象を絞って反映するサブコマンドが用意されているため、これらを使い分けることで確認のサイクルが短くなります。
コマンド | 更新範囲 |
|---|---|
| 設定、データベース、静的コンテンツをまとめて反映 |
| データベースの構成のみ反映 |
| 静的コンテンツのみビルドして配置 |
| ビルド済みの成果物のみアップロード |
| アクティブなデプロイ先を切り替え |
| 記録されているデプロイの一覧を表示 |
活用デモで使ったrayfin up db applyのように、変更範囲を絞ったコマンドを組み合わせることで、全体を再デプロイせず、変更した部分だけを反映できます。
開発用と本番用でワークスペースを分離する
環境を分けて運用する場合は、開発用と本番用でFabricワークスペースを用意し、up switchで接続先を切り替えます。
npx rayfin up switch --list
npx rayfin up switch my-workspace-dev
本番へのデプロイ前には--dry-runで変更内容を事前確認する運用にしておくと、意図しない構成変更を検出しやすくなります。カラムの削除やテーブル名の変更といったデータ損失につながる変更は、通常のデプロイでは停止するため、必要な場合に限り--forceを指定します。
CI/CDへ組み込む際の認証設定
自動デプロイは、Microsoft Entra IDのサービスプリンシパルを使ってrayfin login --service-principalで無人サインインできます。Deploy a Fabric app with GitHub Actionsには、mainブランチへのpushでrayfin upを実行するGitHub Actionsワークフローの構成例が示されています。
導入時に押さえておく点は以下です。
- テナント設定でサービスプリンシパルのFabric API利用を許可しておく必要があります(Fabric管理者が事前に有効化)
- サービスプリンシパルに対して、デプロイ先ワークスペースのContributor以上の権限を付与します
- リポジトリの Secrets に
CLIENT_ID/TENANT_ID/CLIENT_SECRET/FABRIC_WORKSPACE_NAMEを登録し、ワークフローから参照します - 破壊的スキーマ変更(カラム削除など)は既定でブロックされ、
--forceを明示指定した実行のみ通ります
CLIの対応状況はバージョンによって異なるため、導入時はnpx rayfin login --helpを実行し、使用中のCLIで利用できるオプションをご確認ください。
Rayfinの活用シーン
このセクションでは、Rayfinがどのような業務課題の解決に役立つのか、具体的な活用シーンをご説明します。
ラピッドプロトタイピング
インフラが事前構成されているため、着想から動作するURLまでを短時間で到達させられます。新しい業務アプリケーションの効果を検証する場面では、認証、データベース、API、ホスティングを個別に構築すると試作段階でも相応の時間がかかります。
Rayfinでは必要最小限の画面とデータ構造から始められるため、利用部門にプロトタイプを触ってもらい、データ項目や操作フローを調整する用途に向いています。
社内向けツールとダッシュボード
備品管理、申請受付、案件進捗の管理、検査記録の入力といった社内向けツールでは、ログイン制御と権限に応じた表示の出し分けが必要になります。従来はツールごとに認証基盤とAPIサーバーを構築するか、既製のプラットフォームで代替するかの選択になりがちでした。
RayfinはFabric SSOを前提とするため、Fabric appアイテムへの Run and interact 権限を付与されたユーザーが、既存のFabricテナントのアカウントでそのまま利用できます。フロントエンドの実装は自由に設計しつつ、認証まわりの作り込みを省ける点が社内ツールと相性の良い理由です。
データ探索と可視化
Rayfinが管理するSQL databaseに蓄積されたデータをGraphQL経由で参照し、独自のフロントエンドで表示する構成が組めます。定型のレポートでは表現しきれない対話的なフィルタリングや、業務固有のワークフローに沿った画面設計が必要な場面で選択肢になります。
AIエージェントの永続的なバックエンド
AIエージェントを業務で運用する際には、ユーザー設定、処理状況、承認結果、実行履歴といった状態を継続的に保存する仕組みが必要になります。これらを個別のデータストアで管理しようとすると、認証、権限、監査の観点をエージェントごとに作り込むことになります。
Rayfinを使うと、こうした状態を管理するデータモデルとAPIをFabric上に用意できます。エージェント側のコードから型安全にアクセスできるバックエンドを短時間で立ち上げられる点が、この用途との相性の良さです。
Rayfinを導入する前に確認したい制約
Rayfinは適した領域では効果が大きい一方、現時点で明確に対象外となる用途があります。設計の初期段階で確認しておくべき点を整理します。
プレビュー段階であること
2026年8月時点で、Fabric AppsとRayfinはプレビューとして提供されています。API仕様、料金体系、デコレーターの仕様などが今後変更される可能性があります。基幹業務に適用する場合は、正式提供の開始を待ってからの本番展開が安全です。まずは業務価値は高いものの失敗した際の影響が限定的な社内アプリケーションから試行し、段階的に対象を広げる進め方が現実的です。
既存データベースには接続できない
Rayfinはデータベースのスキーマをコード側で管理する設計のため、既定のスキーマを持つ既存データベースを指定してRayfinの管理下に置くことはできません。サポートされるデータベースはSQL Serverで、Fabricへのデプロイでは既定の選択肢となります。既存資産の再利用ではなく、新規アプリケーションのバックエンドとして採用する前提で検討する必要があります。
認証プロバイダーを選べない
デプロイ後に利用できる認証方式は、Microsoft Entra IDによるFabric SSOのみです。独自の認証プロバイダー(他社IdPやOIDCカスタム設定など)を組み込むことはできません。
なお、社外の不特定多数へ公開する用途は、匿名データアクセスを有効化すれば範囲を絞って許可できます(テナント設定と@role('anonymous', ...)の宣言が必要)。匿名アクセスと独自IdPは分けて検討してください。
不向きな用途
公式ドキュメントは、複雑なマルチステップのトランザクションやストアドプロシージャを必要とするアプリケーション、およびFabric SSOとメール/パスワード以外の認証プロバイダーを必要とするアプリケーションを適さない用途として挙げています。ストアドプロシージャを中心に構築されている既存システムの移行先としては、別の構成を含めて検討する必要があります。
まとめ
本記事では、Rayfinの概要、Fabric Appsとの関係、主な特徴、料金、利用手順、活用デモ、実務での運用のポイント、活用シーン、導入前に確認したい制約について解説しました。
Rayfinは、TypeScriptで宣言した1つのデータモデルを起点に、Microsoft Fabric上に業務アプリケーションのバックエンドを構築・デプロイするための開発ツールです。実行環境として動くのはFabric Appsで、SQL databaseや認証、ホスティングといったマネージドサービスを提供します。
活用デモでは、Assetエンティティにlocationフィールドを1つ追加するだけで、SQL側のカラム(nvarchar(100)、NULL可)とRayfinClient側のTypeScript型に同じ変更が反映されることを実機で確認しました。一つの定義を編集すれば、複数のバックエンド要素へ整合の取れた変更を届けられるというRayfinの中心価値を、コードファーストの開発スタイルとして位置づけられます。
現時点ではプレビュー段階であり、既存データベースへの接続や独自の認証プロバイダーには対応していません。適用対象を見極めたうえで、まずは社内向けアプリケーションやAIエージェントのバックエンドといった領域から検証を始めるとよいでしょう。
東京エレクトロンデバイスでは、Microsoft FabricおよびRayfinを活用したアプリケーション基盤の構築を、テナント設定とFabric Appsワークロードの有効化、業務要件に沿ったデータモデルとアクセス制御の設計、Fabric容量のサイジングとコスト設計まで、ワンストップでサポートしています。 Rayfinを活用したアプリケーション基盤の構築をご検討の方は、ぜひお気軽にご相談ください。