Azure HorizonDBとは?
Azure HorizonDBとは、Microsoftが提供する、PostgreSQLを基盤に構築されたクラウドネイティブかつAI対応のフルマネージドデータベースサービスです。
企業が生成AIを活用したアプリケーションを構築する際、トランザクションデータを管理するシステムと、AIモデルを実行する環境が分離していることが多く、これがアーキテクチャの複雑化や開発コストの増大を招く要因となっていました。Azure HorizonDBは、データベース層の根本的な再設計を行うことでこの課題に対応したDBaaS(サービスとしてのデータベース)です。
本サービスの中核には、OSS(オープンソースソフトウェア)として広く普及しているPostgreSQLのリレーショナルエンジンが据えられています。そのため、開発者は既存のコードやドライバ、ツール群をそのまま活用しつつ、高度なセキュリティ、高可用性、およびスケーラビリティを確保できます。
Azure HorizonDBの主な特徴
Azure HorizonDBは「コンピューティング層とストレージ層を完全に分離したクラウドネイティブなデータベース」として設計されており、その全体像は以下の図のような多層構造で表現されます。
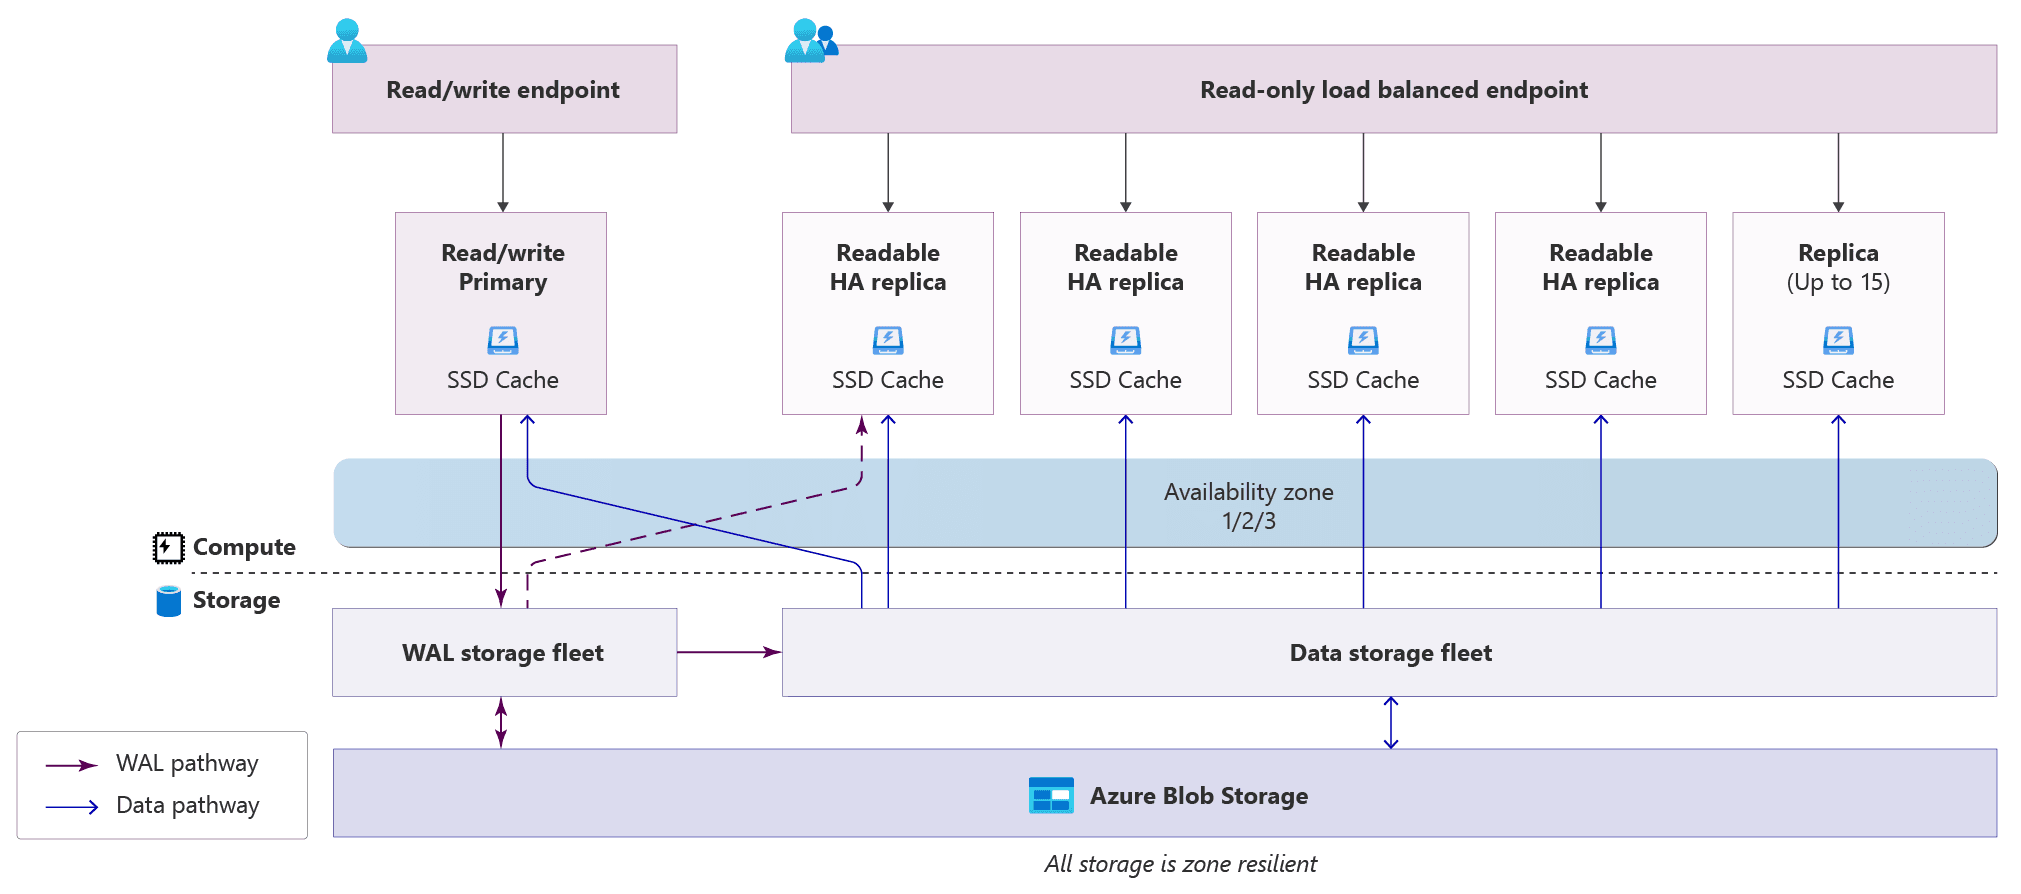
Azure HorizonDBのアーキテクチャ 引用:Microsoft
図の上半分はコンピューティング層で、書き込み可能なプライマリと、読み取り専用かつフェールオーバー候補となる最大15台のHAレプリカで構成されます。下半分は、WAL専用のWAL storage fleetとデータ専用のData storage fleetからなるストレージ層で、破線の境界が両層の分離を示しています。書き込み時には、WALがWAL storage fleetへ送られ、その内容がData storage fleetに非同期で反映されます。さらに、データとWALアーカイブはゾーン冗長のAzure Blob Storageによって永続化されます。
このセクションでは、図に示されたコンピューティングとストレージの分離を軸に、Azure HorizonDBの主な特徴をご説明します。
コンピューティングとストレージの完全な分離
Azure HorizonDBのアーキテクチャにおける利点は、演算処理を行うコンピューティング層と、データを保存するストレージ層が完全に分離されている点です。従来のモノリシック(一体型)なデータベースでは、データ量の増加に伴ってストレージを拡張したい場合、構成によってはCPUやメモリも同時に増強する必要があり、リソースの無駄が生じる場合がありました。
本サービスでは、コンピューティングリソースはステートレス(状態を持たない)なコンポーネントとして扱われます。これにより、開発者はシステムへの負荷に応じて、コンピューティング層のvCore(仮想コア)数やメモリを、ストレージのサイズとは完全に独立して拡張または縮小することが可能です。
また、トラフィックの増加に対応するために読み取り専用のスタンバイレプリカ(複製サーバー)を追加する際にも、共有されている基盤ストレージをそのまま参照するため、巨大なデータのコピーを待つ必要がありません。結果として、レプリカのプロビジョニングが高速化され、障害発生時のフェールオーバー(代替システムへの切り替え)もログの巻き戻しなしで完了します。
ログとしてのデータベース(Database-as-a-log)設計
Azure HorizonDBでは、データベースの書き込み性能を向上させるため、ログとしてのデータベースというクラウドネイティブな設計アプローチが採用されています。通常のデータベースシステムでは、メモリ上で変更されたデータページを定期的にストレージへ書き込むチェックポイントという処理が必要であり、この処理によってデータの読み書きが瞬間的に増加し、システムの応答性を低下させることがありました。
Azure HorizonDBでは、WAL(先行書き込みログ)をデータ更新の基準として扱います。通常のデータベースのように、更新後のデータページをそのままストレージへ書き込むのではなく、まずは更新内容だけを専用のWALサービスに送ります。ストレージ側では、そのログをもとにバックグラウンドでデータページを順次再構築します。
この仕組みによって、ストレージへの無駄な書き込みを減らし、書き込み処理の負荷を抑えられます。保存データが数TB規模まで増えても、安定した低遅延の書き込み性能を維持しやすい点が特長です。
AIネイティブなクエリ構築
AIを活用したアプリケーションを構築するための機能が、データベースエンジン内部に直接統合されている点もAzure HorizonDBの大きな強みです。通常、AI機能を利用するためには、データベースからデータをバッチ処理などで抽出し、外部のAIプラットフォームに送信する仕組みが必要でした。
Azure HorizonDBでは、azure_aiという拡張機能を利用することで、SQLのクエリから直接、テキスト生成、エンティティ抽出、データのランク付けといった操作を関数として呼び出すことができます。
AIモデルの管理
AIモデル管理機能を有効にすることで、開発者はAPIエンドポイントや認証キーの管理といったインフラストラクチャの運用をAzure HorizonDBに委任することができます。データベース内でチャットモデルや埋め込みモデルが自動的にプロビジョニングされ、常に最新の状態で維持されるため、モデルのライフサイクル管理に要する手間を削減することができます。
現在はプレビュー中のため、この機能を利用するためには、事前にMicrosoftが提供する専用の参加フォームからアクセス要求を申請する必要があります。承認まで時間がかかる場合もあるため、利用を検討している場合は早めに申請を行いましょう。
宣言型AIパイプラインと持続的ワークフロー
生成AIの実運用において課題となるのが、長文データを適切なサイズに分割するチャンク化や、それらを数値化するベクトル埋め込みの生成といった一連のデータ準備プロセスです。Azure HorizonDBは、これらの多段階にわたるワークフローをSQLを用いて宣言的に記述し、データベース内でパイプラインとして実行する機能を備えています。
この基盤を支えているのが、pg_durableと呼ばれる耐久性のある実行エンジンです。一時的なネットワークエラーでAPIの呼び出しに失敗した場合でも、システムが自動的に再試行を行い、中間状態が保存されるため、完了済み処理の重複実行を避けながら中断ポイントから再開しやすくなります。
Apache AGEによるグラフデータベース機能
リレーショナルデータやベクトルデータに加えて、複雑な関係性を分析するためのグラフデータベース機能もサポートされています。標準のPostgreSQLで多対多の関係性をたどる場合、テーブル間のJOIN(結合)操作を何重にも行う必要があり、パフォーマンスが著しく低下することがあります。
Azure HorizonDBでは、Apache AGE拡張機能を利用することで、エンティティ(顧客、製品、口座など)をノードとし、その関係性をエッジとして直接格納できます。これにより、Cypher(グラフデータベース用の問い合わせ言語)を用いて、ソーシャルネットワークやサプライチェーンにおけるマルチホップ(複数のノードを経由する)パターンを高速に探索することが可能になります。
Azure HorizonDBの料金
Azure HorizonDBの料金は、実際にプロビジョニングしたリソースや使用したデータ量、AIモデルの使用量に対してのみ支払いが発生する従量課金制です。
以下に、コンポーネントごとにまとめた料金表を示します。
課金対象リソース | 課金単位 | 課金仕様 |
|---|---|---|
コンピューティング | vCore数 × 時間 | プライマリインスタンスおよび高可用性(HA)レプリカの双方に対して、割り当てられたvCore数に基づいて時間単位で課金されます。 単価はリージョンや通貨によって異なるため、公式料金表で対象リージョンの最新レートを確認してください。 |
データベースストレージ | GiB × 月 | データ量の増加に伴ってシステムが自動的にストレージを拡張し、実際に使用されたデータとログの容量に対してのみ課金されます。 |
バックアップストレージ | GiB × 月 | クラスター作成時に割り当てられた初期サイズの100%までは無料で提供されます。 これを超過した分のスナップショットおよびWALアーカイブ容量に対してのみ課金が発生します。 |
AIモデル利用料 | モデルごとの標準料金 | AI Model Management機能自体には追加料金は発生しません。 データベース内で利用したチャットモデルや埋め込みモデルの使用量に応じて、Microsoft Foundryの標準料金がAzure HorizonDBの請求に統合されて課金されます。 |
2026年8月時点で、Azure HorizonDBを利用可能なリージョンは以下の通りです。
日本リージョンでは利用できないため注意が必要です。
- 米国中部
- 米国東部
- 米国西部 2
- 米国西部 3
- スウェーデン中部
- オーストラリア東部
上記の内容は2026年8月時点の情報です。最新のリージョン提供状況はAzure HorizonDB公式ドキュメント、料金の最新レートはAzure HorizonDB公式料金表をご覧ください。
Azure HorizonDBの利用手順
それでは、実際にAzure HorizonDBを利用する手順を解説します。
ここではAzureポータルを用いる手順をご説明しますが、Azure CLI、またはAzure Resource ManagerテンプレートからAzure HorizonDBを利用することも可能です。
1.Azureポータルにアクセス
最初のステップとして、Azureポータルの「リソースの作成」から「Azure HorizonDB」を選択し、「作成」をクリックします。
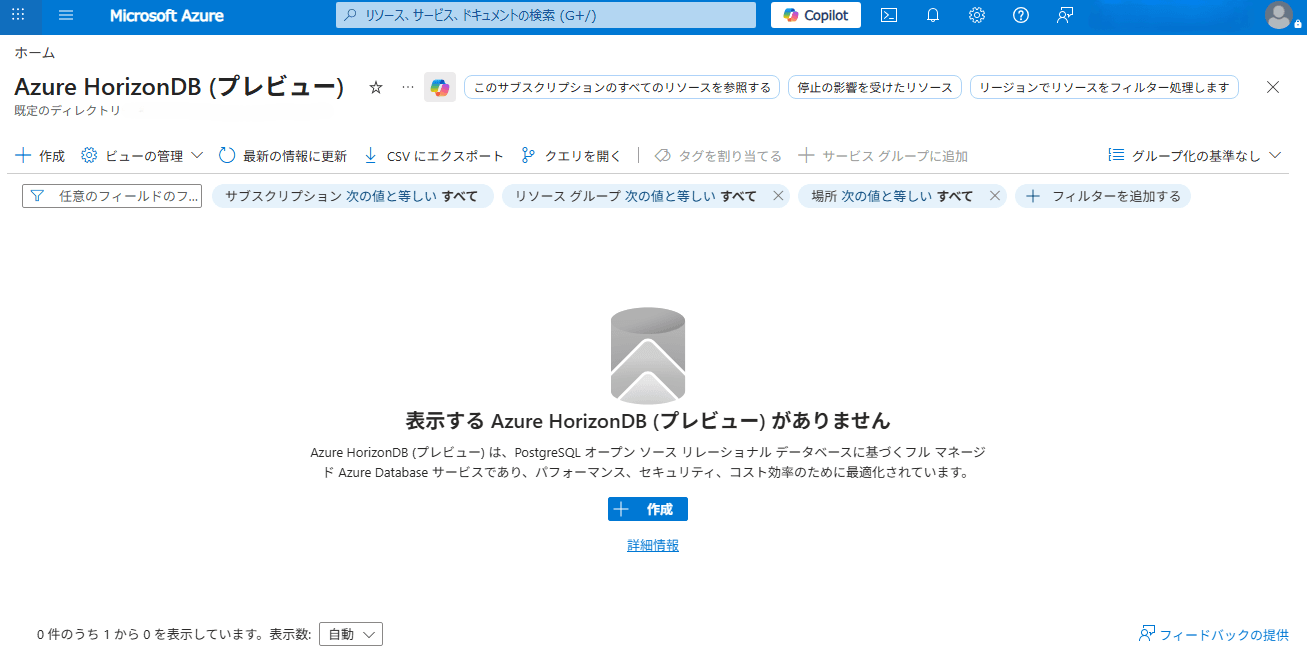
Azureポータルにアクセス
2.クラスターの作成
作成ウィザードでは、課金対象となるサブスクリプションとリソースグループを指定し、クラスターに一意の識別名を付与します。
パフォーマンスを確保するため、コンピューティングの構成画面でビジネス要件に合わせたvCore数を選択し、高可用性を担保するために読み取り可能なHAレプリカの数を設定しましょう。
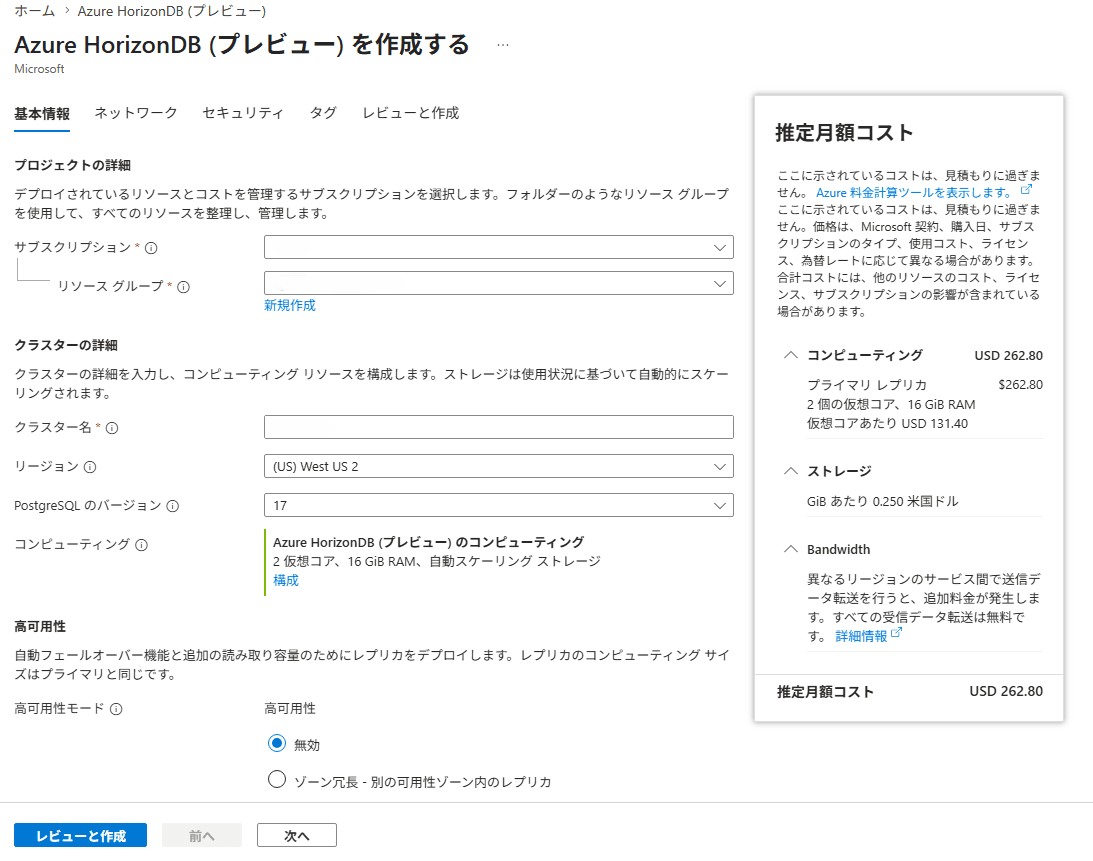
クラスターの作成
3.ネットワークの分離とファイアウォール設定
データベースの安全性を確保するため、クラスター作成ウィザードでネットワーク接続の構成を行います。Azure HorizonDBは、初期状態でパブリックIPアドレスからの接続が許可されないセキュアな設計となっています。
インターネットを経由して接続を試みる場合、「パブリック アクセス(許可されているIPアドレス)」を選択し、接続元のIPアドレスをファイアウォール規則に明示的に追加する必要があります。
開発環境からのアクセスを円滑にするため、ウィザード内の「現在のクライアントIPを追加」オプションを利用することが有効です。
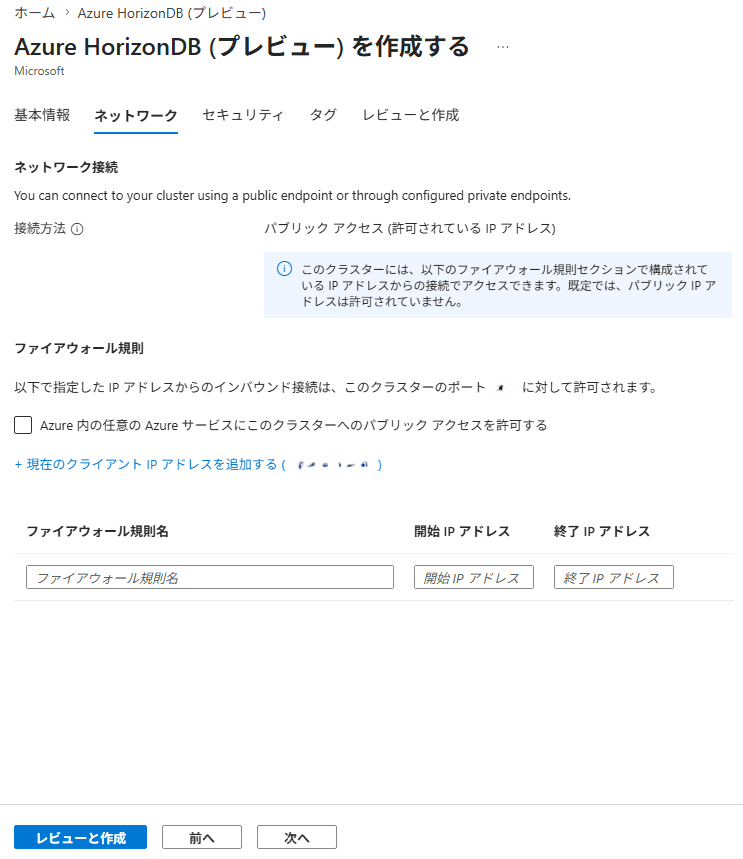
ネットワークの分離とファイアウォール設定
クラスターの作成が完了すると、以下のようにAzureポータル上から状態を確認できるようになります。
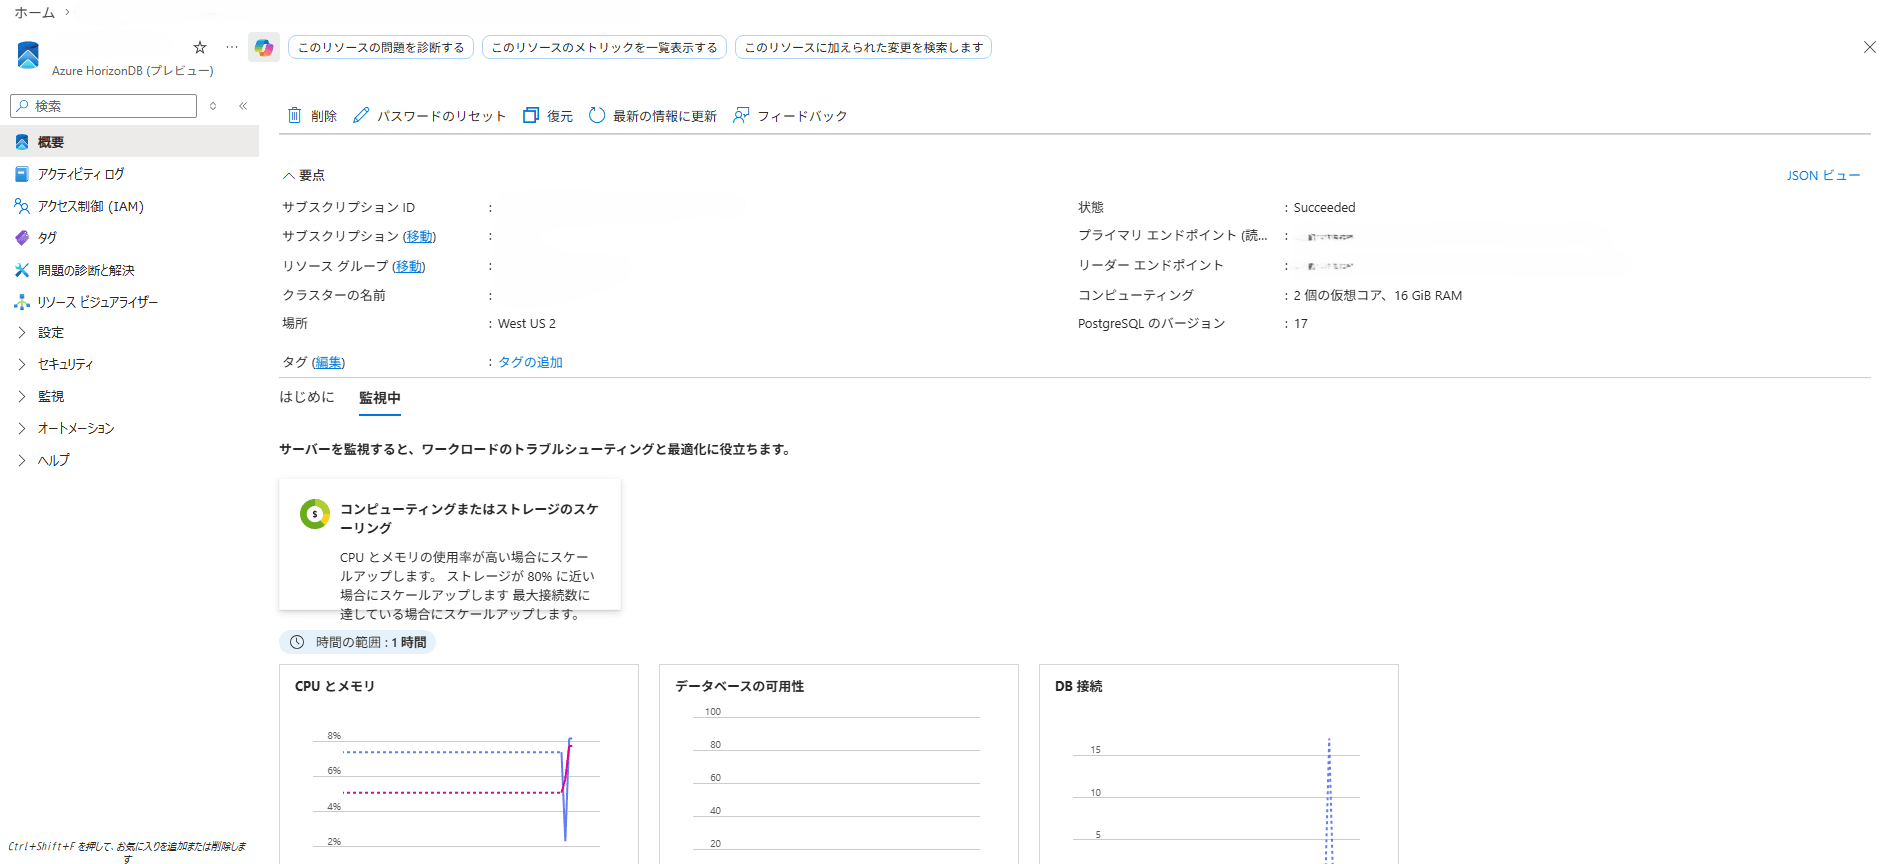
Azureポータルで作成したAzure HorizonDBクラスター
上記の手順で実際にAzure HorizonDBの利用を開始できます。より詳細な手順は、Azure HorizonDB公式ドキュメントをご覧ください。
Azure HorizonDBを実務で活かす実装のポイント
このセクションでは、データベースのパフォーマンスと開発者の生産性を引き出すための、Azure HorizonDBの使い方のコツをご説明します。
ワークロードの特性に合わせたインデックスの選択
ベクトル検索の実装において、データセットの規模や要件に応じて適切なインデックスの種類を使い分けることが、検索の精度とインフラコストを最適化するコツです。
データセットが10万件未満で速度要件が厳しくない場合は、インデックスを作らず完全走査に任せても実用的な性能が得られます。データが静的で更新頻度が低く、なおかつRAMに収まる規模であれば、HNSW(階層型ナビゲーションスモールワールド)インデックスによって高い再現率と検索速度を両立できます。
一方、本番AIワークロードでのデフォルト推奨はDiskANNです。データが継続的に増加するケースや、カテゴリ・日付といったメタデータによるフィルタ付き検索を併用する環境で強みを発揮します。DiskANNはディスクを活用したアルゴリズムであるため、限られたメモリ容量のクラスターであっても効率的に動作します。インデックス選択の判断軸は、データ件数だけでなく、RAMに収まるか・更新頻度・メタデータフィルタの有無・要求される再現率を組み合わせて評価してください。
グラフ推論クエリと視覚化ツールの連携
Apache AGEを利用して複雑なデータ関係を分析する際、クエリの構築と結果の検証プロセスを効率化するアプローチが求められます。ノードやエッジをたどるCypherクエリを構築する際、テキストベースの出力だけでは関係性の全体像を把握しにくいという課題があります。
IDEの拡張機能などで提供されているApache AGEグラフビジュアライザーを使用することで、クエリ結果を対話的なノードとエッジのネットワーク図として可視化できます。この視覚化ツールを正常に機能させるためのコツとして、クエリ内で特定のプロパティ(名前やタイトルなど)だけを抽出してスカラー値として返すのではなく、RETURN a, r, bのようにノードとエッジの完全なオブジェクトを返す必要があります。
また、ノード内に意味のあるラベルを表示させるために、クエリ内でSET a.disp_label = a.titleといった形で表示用のプロパティを明示的に指定することで、分析の効率が向上します。
持続的関数を用いた長期プロセスの自動化
Azure HorizonDBでは、定期的なデータのETL(抽出・変換・読み込み)処理や、AIモデルを呼び出す長時間のバッチ処理を行う際、外部のワークフローオーケストレーターに依存しない設計が可能です。
Azure HorizonDBは、持続的関数の概念がSQL内に持ち込まれており、df.sleep(指定時間の待機)やdf.http(外部APIの呼び出しと自動再試行)、並列実行を制御する演算子を組み合わせて、長時間稼働するワークフローを記述できます。これにより、処理の途中でデータベースが再起動されるような事態が発生しても、プロセスは中断されたポイントから自動的に再開されます。
Azure HorizonDBの活用シーン
このセクションでは、Azure HorizonDBによって解決できるビジネス上の課題を具体的にとらえるために、活用シーンを用途別にご紹介します。
小売・Eコマースにおける高度なパーソナライズ基盤
小売業やEコマースのプラットフォームでは、顧客ごとのパーソナルショッピングの提供が重要です。Azure HorizonDBは、商品の在庫情報や価格を管理する高スループットなトランザクション処理基盤として機能しつつ、AIを利用したレコメンデーションエンジンを同一データベース上で稼働させることができます。
利用者が「キャンプで使える、軽くて赤いテントを探している」と入力した場合、ベクトル検索による意味の理解と、型番やブランド名によるキーワード検索を統合したハイブリッド検索を利用することで、的確な商品を提示します。さらに、利用者の過去の購買履歴や閲覧傾向といった状態をデータベースに保存しておくことで、文脈を踏まえたレコメンデーションシステムのバックエンドとして高い効果を発揮します。
金融機関における不正検知とナレッジグラフの構築
金融サービス業界では、クレジットカードの不正利用やマネーロンダリングといった金融犯罪をリアルタイムで検知し、阻止するコンプライアンス体制が求められます。多くの場合、単一の口座の取引履歴を見るだけでは不正を見抜くことはできず、背後に潜むネットワークの構造を明らかにする必要があります。
ここで、Apache AGEを利用したグラフデータベース機能が有効です。個人、口座、利用デバイス、IPアドレスといった要素をノードとし、送金履歴をエッジとするナレッジグラフを構築することで、「短期間に共通のデバイスを経由して多数の口座間で少額送金を繰り返している」といった関係性を割り出すことができます。
SaaSプラットフォームのバックエンド拡張
複数のテナントに対してサービスを提供するSaaSプラットフォームにおいて、事業の成長に伴うトラフィックの増加にどのように対応するかは大きな課題です。アクセスの急増によってデータベースのパフォーマンスが低下すると、サービス全体の信頼性が損なわれます。
Azure HorizonDBは、コンピューティングとストレージが分離されたアーキテクチャを持つため、読み取り負荷の増加に対しては、読み取り専用レプリカを追加することで柔軟にスケールアウトできます。また、重いレポート集計処理や顧客離れ予測の分析処理を、読み取り専用のスタンバイレプリカにルーティングすることで、基幹トランザクション処理のパフォーマンスを犠牲にすることなく、システム全体を安定稼働させることができます。
法務および専門調査におけるハイブリッド検索とセマンティックランク付け
法務業界や専門的な調査機関では、膨大な判例、契約書、規制文書の中から関連する情報を正確に探し出し、文脈に沿って解釈する作業に多大な負担がかかります。この領域では、一部のキーワードが一致するだけの検索システムでは業務要件を満たすことができません。
Azure HorizonDBのAIパイプライン機能を用いて文書を継続的にインデックス化し、ハイブリッド検索とセマンティックなランク付けを組み合わせることで、クエリに対する関連性に基づいた高度な情報抽出が可能になります。
Azure HorizonDBの注意点
Azure HorizonDBはエンタープライズ向けの強力な機能を提供する一方で、アーキテクチャの制約やプレビュー段階特有の制限事項も存在します。ここでは、導入を成功させるために事前に把握しておくべき、Azure HorizonDBの注意点をご説明します。
バックアップおよびディザスタリカバリの仕様制限
ミッションクリティカルなシステムにおいて、データのバックアップと災害時の復旧(ディザスタリカバリ)計画は特に重要です。Azure HorizonDBは、パフォーマンスに影響を与えない自動バックアップ機能を提供していますが、現在のプレビュー版ではバックアップの保持期間が最大7日間に固定されています。
さらに、Azure HorizonDBはストレージとバックアップについては同一リージョン内での耐障害性(ゾーン冗長)をデフォルトで備えていますが、コンピューティング層のHA(高可用性)を確保するにはプライマリに加えて少なくとも1台のレプリカを構成する必要があります。また、地理的に離れた別のリージョンにデータを複製するクロスリージョンリードレプリカ機能は2026年6月時点でサポートされていません。そのため、別地域でのシステム復旧がコンプライアンス上必須となるプロジェクトにおいては、将来的な機能拡張を待つか、データエクスポート運用を設計に組み込む必要があります。
マネージドキーの制約
エンタープライズ環境では、コンプライアンス要件を満たすための厳格な暗号化の設定が求められます。
Azure HorizonDBは、保存データの暗号化をデフォルトでサポートしていますが、使用される暗号化キーはAzure側で自動管理されるサービスマネージドキーに限定されており、顧客自身が管理するカスタマーマネージドキーを持ち込んで適用することはできません。
コネクションプーリング機能の外部依存
Webアプリケーションやマイクロサービスアーキテクチャでは、多数のクライアントからの接続要求を効率的に処理するために、データベースのコネクションを使い回すコネクションプーリングが推奨されます。
しかし2026年6月時点で、Azure HorizonDBは、データベースクラスター内部に組み込まれたコネクションプーリング機能は提供されていません。したがって、高い同時接続数が予想されるアプリケーションを構築する場合は、データベースと独立したコネクションプール用ミドルウェアを自らデプロイし、トラフィックを適切に管理するアーキテクチャを構築する必要があります。
まとめ
本記事では、Azure HorizonDBの主な特徴や料金、利用手順、活用シーン、導入時の注意点について解説しました。
Azure HorizonDBは、PostgreSQL互換の使いやすさを保ちながら、コンピューティングとストレージの分離、AIネイティブな機能、グラフデータベース対応などを備えたフルマネージドデータベースサービスです。
トランザクション処理とAI活用を単一の基盤に集約できるため、システム構成の複雑化を抑えつつ、開発効率や拡張性の向上を目指せます。一方で、プレビュー段階ならではの制約や利用可能リージョンの制限といった注意点もあるため、実運用を見据える場合は最新の提供状況を確認しながら導入を検討することが重要です。
東京エレクトロンデバイスでは、Azure HorizonDBを活用した生成AIアプリケーション基盤の設計・導入をワンストップでサポートしています。ベクトル検索やDiskANNを活用したRAGアーキテクチャの設計、Public Preview期間中の制約を踏まえた導入計画、本番運用を見据えたコスト・性能設計を軸に、貴社の要件に合わせた導入をご支援します。
生成AIとトランザクションデータを同一基盤で扱うアーキテクチャをご検討の方は、ぜひお気軽にご相談ください。