Web IQとは?
Web IQとは、AIエージェントが推論のために必要とする最新のウェブ情報を、リアルタイムかつ効率的に取得できるように設計されたMicrosoftの次世代検索API群です。Microsoftが提供するエンタープライズ向けAI基盤「Microsoft IQ」の一角を担うコンポーネントとして位置付けられており、Microsoft Foundry上で構築するAIエージェントに組み込む形で利用されます。
これまでのAI開発では、LLM(大規模言語モデル)が過去の学習データに依存してしまうため、最新のニュースや市場動向を回答に反映させることが難しいという課題が存在しました。また、人間がブラウザで閲覧するためのウェブページ全体をそのままAIに読み込ませると、不要な装飾要素や関連リンクなどのノイズが多く含まれるため、処理コストが膨大になり、回答の生成速度も低下するという構造的な問題がありました。
Web IQはこれらの課題に対応するため、ウェブページを人間向けに整形して返すのではなく、AIモデルが直接読み取りやすいセマンティック(意味的)なデータの塊として抽出したうえで返却する設計となっています。関連性の高い一節(パッセージ)と、その出典URL・タイトルなどのメタデータを含む構造化データとして返るため、LLMのコンテキストにそのまま投入して推論の根拠として活用することが可能です。
Grounding with Bing SearchとWeb IQの違い
Web IQを理解するうえで混同しやすいのが、既存の「Grounding with Bing Search」との違いです。どちらも公開ウェブ情報をAIの回答根拠として利用するための仕組みですが、想定している利用シナリオと、開発者が扱える情報の粒度が異なります。Grounding with Bing Searchは、Microsoft FoundryやAzure AI Searchにおいて、AIモデルに最新の公開ウェブ情報を参照させるためのアドオン機能です。エージェントやアプリケーションが必要に応じてBing検索を呼び出し、その結果をもとに回答を生成できるため、既存のAzure環境に比較的短期間で導入しやすい入口として位置付けられます。
一方、Web IQは、複数ステップで推論するAIエージェントや大規模な業務アプリケーション向けに設計された、よりAIネイティブな検索基盤です。単に検索結果のリンクや要約を渡すのではなく、LLMのコンテキストに直接投入しやすい引用可能な構造化データや、関連性の高いパッセージを返す点に特徴があります。導入検討時には、シンプルにAIエージェントの回答にウェブ情報の裏付けを追加したいのか、それとも根拠抽出まで含めた本格的なエージェント基盤を構築したいのかを基準に考えるとよいでしょう。前者ではGrounding with Bing Search、後者ではWeb IQが有力な選択肢になります。
Web IQの主な特徴
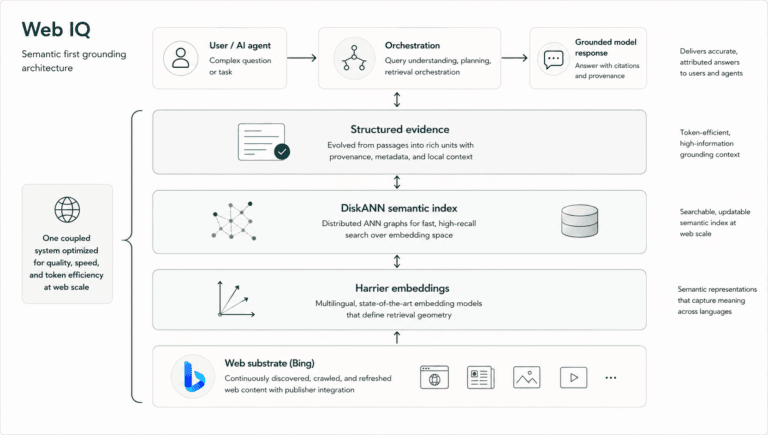
Web IQは「セマンティック検索を第一に据えたグラウンディング基盤」として設計されており、その全体像は以下の図のような4つの基盤層を中心とするアーキテクチャで表現されます。
Web IQ 引用:Microsoft Command Line
図の下から順に、Bingがクロール・更新し続けるウェブコンテンツ層(Web substrate)、多言語対応の埋め込みモデルで意味表現を生成する層(Harrier embeddings)、埋め込みを高速に検索する分散インデックス層(DiskANN semantic index)、質問に関連する文章を出典情報付きで抽出する層(Structured evidence)が積み上がる構造となっています。
上部には、ユーザーやAIエージェントからの質問を解釈し、検索戦略を計画・実行して、回答生成に用いる証拠を組み立てるオーケストレーションが配置されており、Web IQがなぜ「AIエージェント向けの検索基盤」として位置付けられるのかが視覚的に整理されています。
このセクションでは、図に示された4つの基盤層それぞれの特徴について、AIエージェント開発にもたらす利点を交えながらご説明します。
セマンティック検索と多言語埋め込みモデルの採用
従来の検索システムでは、入力されたキーワードが文章内に含まれているかを照合する「キーワード検索」手法が主要な検索経路として使われることが多くありました。この方式では、同じ意味を持つ表現でも語彙が異なる場合には関連情報を取りこぼすことがあったため、AIエージェントが幅広い情報源から推論の根拠を集めたい場面では検索結果に偏りが生じやすいという課題がありました。
Web IQでは「セマンティック検索」と呼ばれる、文章の文脈や意図を数値化してベクトル空間に配置するアプローチを第一段階の主要な検索経路とし、キーワードによる照合も補助的に活用しています。この基盤を支えているのが、Harrier(ハリアー)と呼ばれる多言語対応のテキスト埋め込みモデルです。Harrierは94の言語に公式対応しており、2億7000万から270億までのパラメータサイズを持つ複数のモデルが用途に応じて使い分けられます。
これにより、表面的なキーワードが一致していなくても、意味が類似している関連情報を高い精度で探し出すことが可能となります。日本語で入力された質問に対して、英語や他言語で書かれた技術記事や公式ドキュメントを横断的に検索できるため、多言語ソースを含めた根拠収集が必要なグローバル企業のAIエージェントとも相性がよい設計となっています。
高速かつスケーラブルな近似最近傍探索
エージェント型のAIが複雑なタスクを処理する際、一度のユーザー質問に対してシステム内部で複数回の検索が繰り返されることが多くあります。このような環境下で実用性を保つためには、検索1回あたりの遅延を極力抑える必要があります。Web IQは、DiskANN3と呼ばれる近似最近傍探索(ANN:Approximate Nearest Neighbor)インデックスの技術を統合しています。新しい情報をインデックスへ追加する際にも、インデックス全体を再構築することなく、数ミリ秒で検索可能にするストリーミング更新機能が実現されています。従来のインデックス方式では、新規データの追加時にインデックスを再構築するオーバーヘッドが発生し、更新頻度と検索性能がトレードオフになりがちでしたが、DiskANN3はこの制約を大きく緩和しています。
Microsoft公式の測定結果によれば、95パーセンタイル値(レイテンシの上位5%を除いた実質的な上限)で165ミリ秒未満という短い応答速度を達成しており、これは同等の代替システムと比較して約2.5倍の速度であると報告されています。1タスクで複数回の検索が発生するエージェントシステムにおいても、ユーザー体感の遅延を抑えた運用が可能です。
パッセージ単位の証拠抽出とトークン効率の向上
Web IQの中核的な特徴の一つは、ウェブページ全体をそのままシステムに引き渡すのではなく、質問に対する答えが含まれる文章の一部(パッセージ)だけを抽出して返す点にあります。この抽出結果は証拠オブジェクト(evidence object)とも呼ばれ、元のウェブページから切り離されても文脈が理解できるよう、出典URL・タイトル・タイムスタンプなどの構造化されたメタデータが付与されています。
言語モデルに情報を入力する際、トークンと呼ばれるデータの単位が消費されますが、トークン数の増加はそのまま処理時間と運用コストの増加に直結します。Web IQでは不要な文脈を取り除いた密度の高いパッセージだけを返すため、少ないトークン数で質の高い推論結果を得られるようになり、システム全体の効率化に寄与します。パッセージには出典情報が付随するため、アプリケーション側でこれを回答に埋め込むことで、ユーザーに対して参照元の在りかを提示することも可能です。生成AIの回答に信頼性を求める業務利用シーンにおいて、この構造は重要な設計要素となります。
MCPを通じたシームレスな統合
システムを導入する開発者にとって、特定のベンダーの言語モデルや開発フレームワークに縛られてしまうことは、将来的なアーキテクチャ変更の柔軟性を損なう大きなリスクとなります。Web IQは、MCP(Model Context Protocol:AIモデルと外部の知識ソースを接続するためのオープンな標準規格)に対応しています。
データのやり取りはJSON-RPCと呼ばれる汎用的なデータ通信規約で行われるため、Microsoftの環境だけでなく、他社の言語モデルや既存のAIプラットフォームに対しても、大きな改修を加えることなくウェブ検索機能を統合することが可能です。Anthropic ClaudeやOpenAI系モデル、社内開発のエージェントフレームワークなどを併用している組織においても、Web IQをMCPサーバーとして扱うことで、統一的な検索基盤として活用できます。
MCP対応の恩恵は、複数のエージェントランタイムを並行運用している企業にとって特に大きく、検索機能の実装をエージェントごとに重複させることなく、一元的なウェブ検索レイヤーとして構築できる点が実務上の価値につながります。
Bingのウェブインデックスとパブリッシャー尊重の設計
ビジネスで利用するAIエージェントは、情報の正確性だけでなく、著作権やウェブサイト管理者の意向を尊重して動作しなければなりません。Web IQは、Bingが長年蓄積してきたグローバルなウェブインデックスとクロール技術を基盤としており、大規模なウェブ検索インフラの資産をそのまま活用できる形になっています。
robots.txtなどのロボット排除プロトコル(クローラーのアクセス範囲を制御する仕組み)や、パブリッシャーの制御・アクセス設定を尊重するよう設計されています。ウェブ情報を大量に扱うAIエージェント基盤において、こうしたクロール設計上の配慮が製品側で組み込まれていることは、コンプライアンス方針を検討する情報システム部門にとって導入時の重要な確認事項となります。
Web IQの料金体系
現在、Web IQは一部のエンタープライズ顧客向けに限定アクセスという形で提供されています。そのため、2026年8月時点では利用料金が公開されていません。そのため、導入を希望する場合は、Web IQの待機リストに登録する必要があります。
登録フォームの主な入力項目は以下の通りです。
カテゴリ | 主な入力項目 |
|---|---|
担当者情報 | 企業のメールアドレス/氏名/職種 |
企業情報 | 企業名/企業のWebサイト(任意)/国・地域/企業規模/政府関係組織かどうか |
Web IQの利用意向 | Web IQを知った経路/Web IQの利用目的/業務利用に関する確認 |
既存の利用環境 | 現在のAIエージェントに利用しているグラウンディング・検索サービス/Azureの使用状況 |
申請時には、想定ユースケースや現在利用しているグラウンディング・検索サービスの記入が求められます。単にサインアップすれば使えるサービスではないため、社内で想定している具体的な業務シナリオを整理したうえで申請することが望まれます。
利用にはMicrosoftによる承認が必要です。審査に時間がかかる場合もあるため、利用を検討する場合は早めに登録を行いましょう。
※上記の内容は2026年8月時点の情報です。最新情報はWeb IQ公式サイトをご覧ください。
Web IQの利用手順
それでは実際に、Microsoft FoundryからWeb IQを利用する手順をご説明します。
Microsoft Foundryとは、AIエージェントや生成AIアプリケーションの作成・評価・運用を一元的に行える、MicrosoftのAI開発プラットフォームです。Web IQは、Foundry上のエージェント設定画面から追加するツールの一つとして提供されており、既存のFoundryエージェント開発フローにそのまま組み込む形で利用します。
1. 限定アクセスへの申請と承認の取得
最初のステップとして、Web IQを利用するための権限を取得します。Web IQの待機リストに登録し、Microsoftからの承認を待ちましょう。
審査を経て承認が得られると、Web IQを利用する権限が付与されます。
限定アクセスへの申請 引用:Web IQ
2. Microsoft Foundryにアクセス
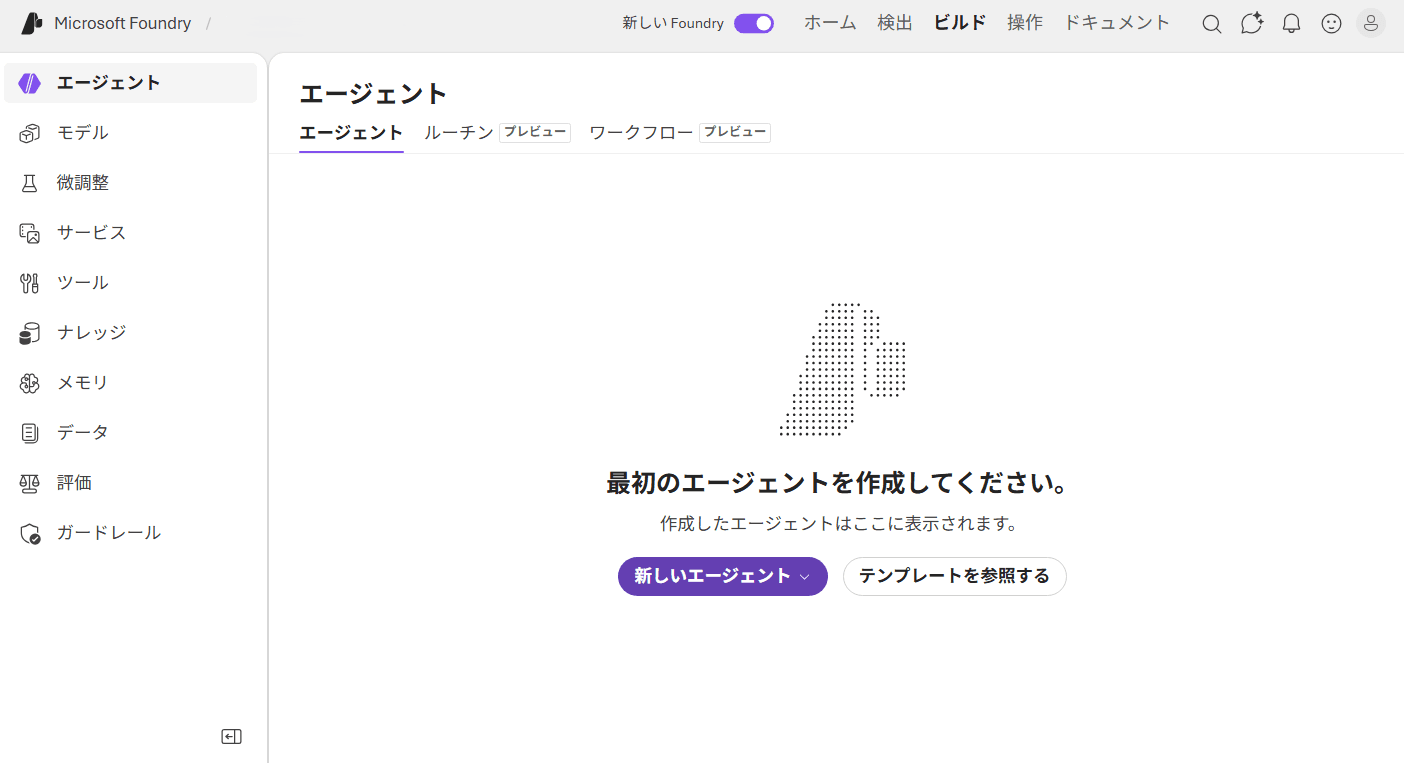
続いてMicrosoft Foundryにアクセスし、「新しいエージェント」をクリックしてAIエージェントを作成します。
はじめてMicrosoft Foundryを利用する場合は、まずMicrosoft Foundryのプロジェクトを作成しましょう。プロジェクトはFoundryにおけるエージェントやリソースの管理単位であり、初回作成時に必要なAzureリソースが併せて用意されます。
Microsoft Foundryにアクセス
3. Web IQの追加
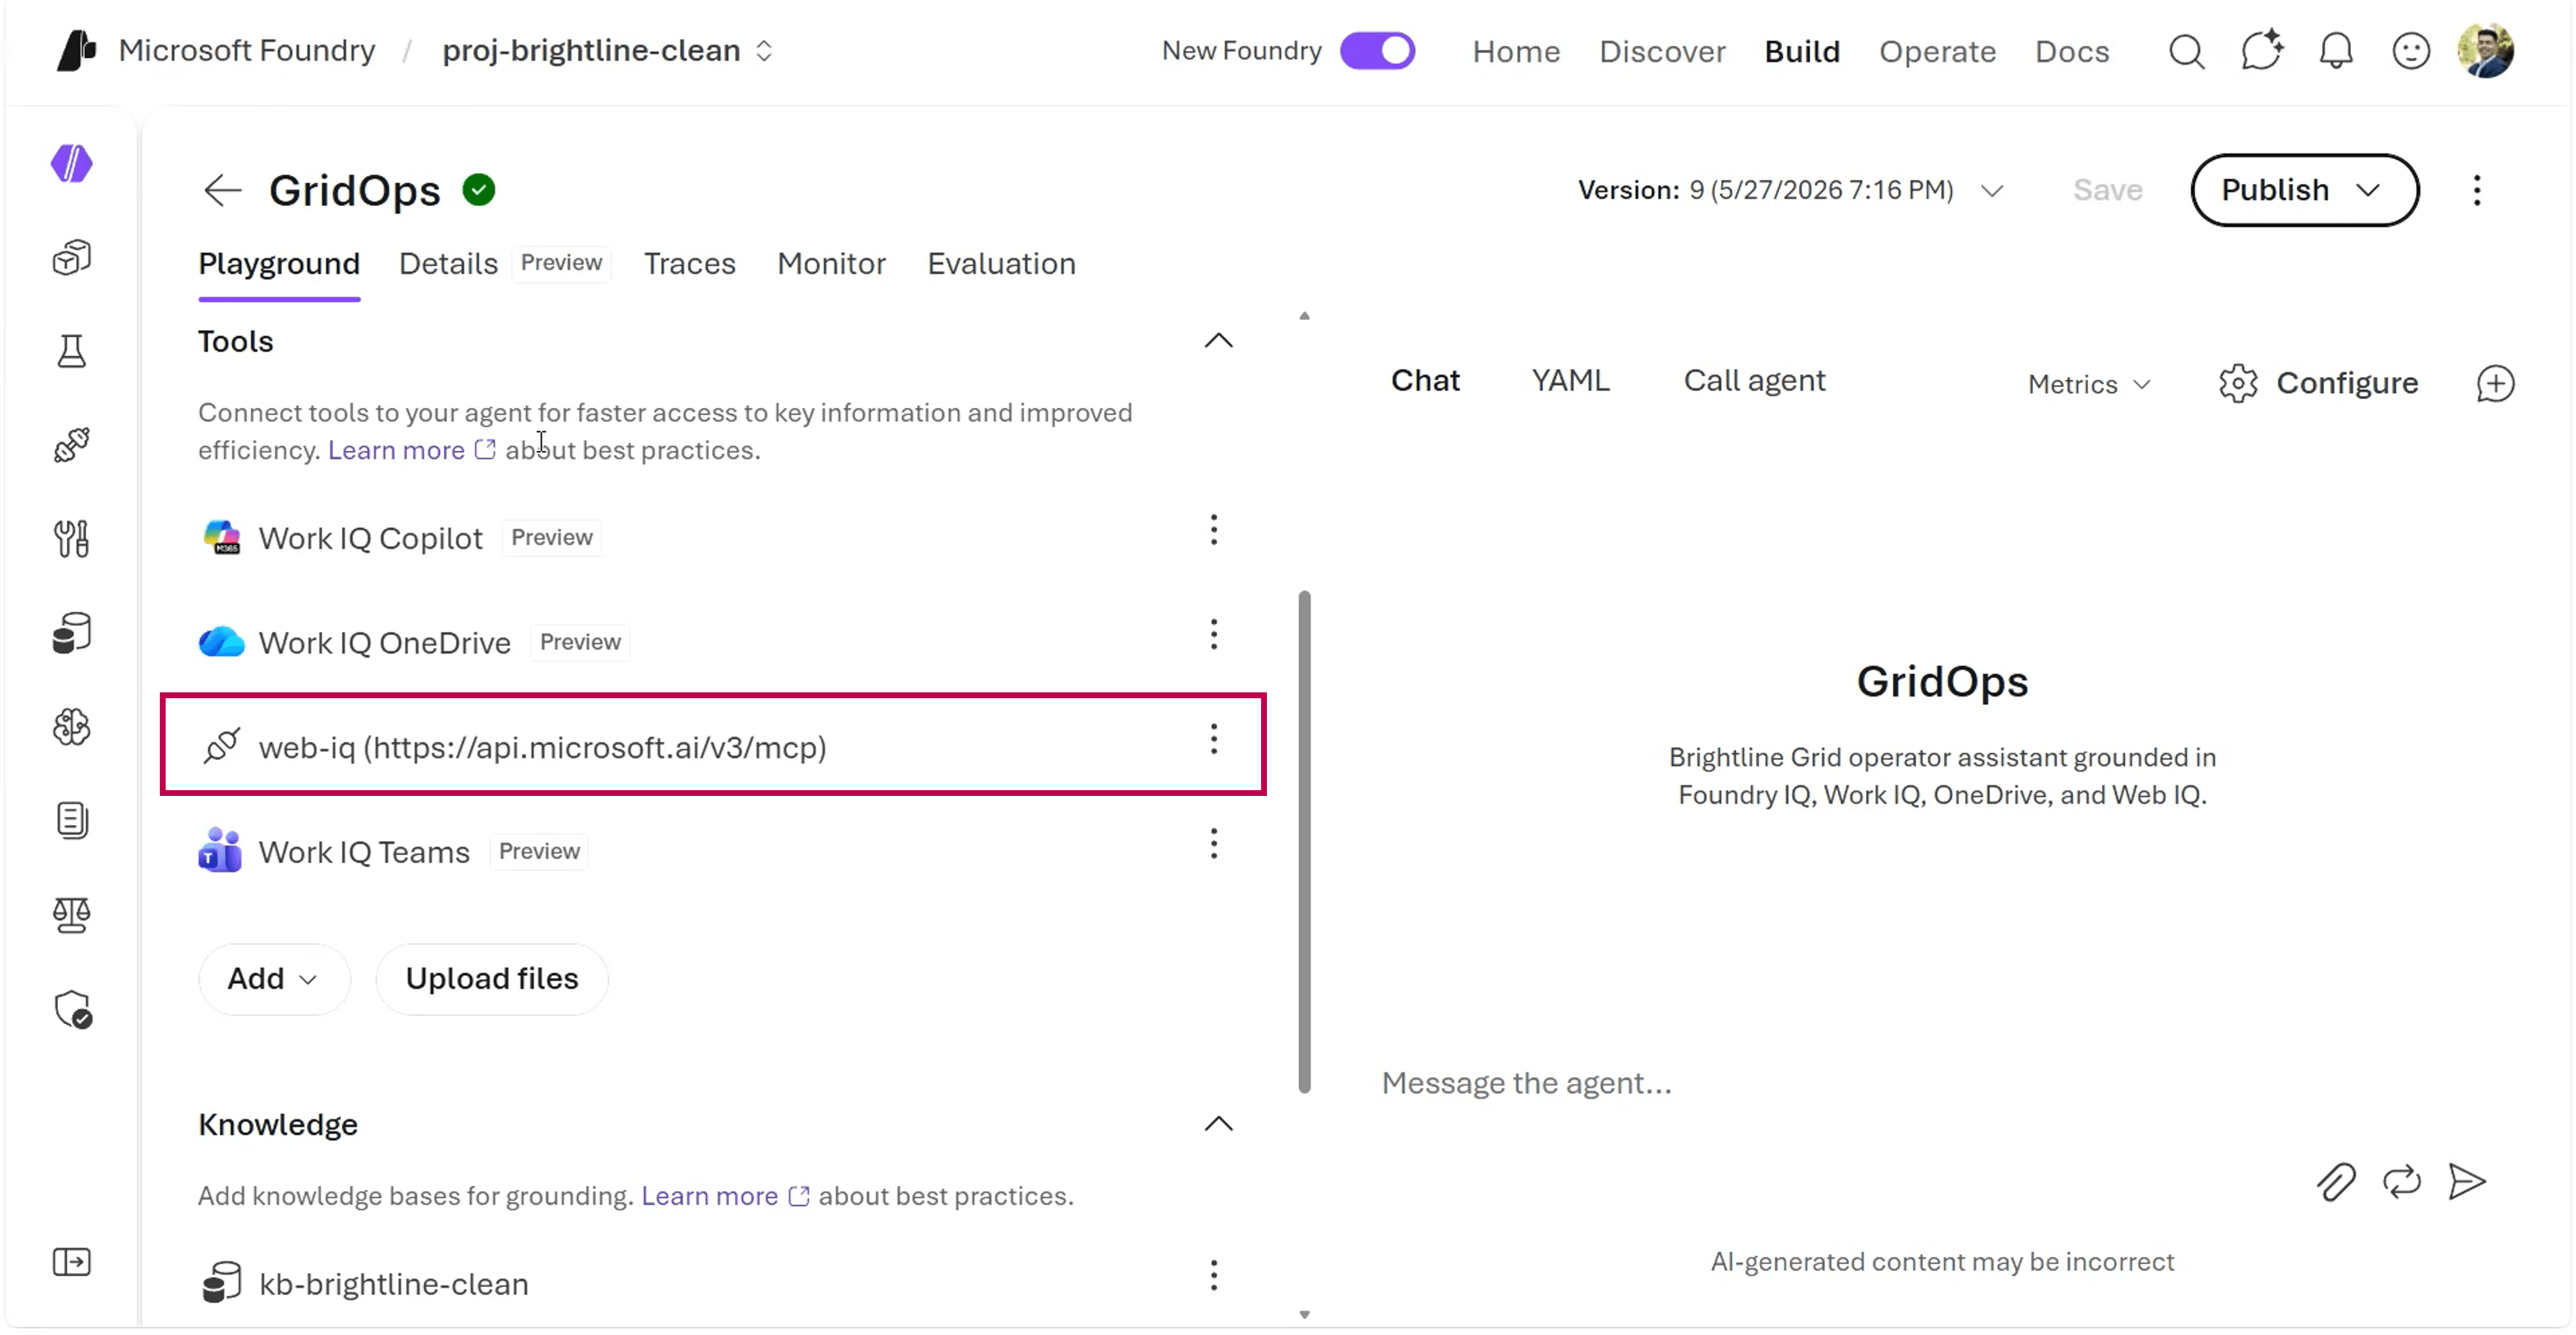
エージェントの作成が完了したら、ツールタブの「追加」からWeb IQを選択し、エージェントに追加します。追加後は、エージェントがユーザーからの質問を処理する際に、必要に応じてWeb IQを呼び出してウェブ情報を検索するようになります。
Web IQの追加 引用:Microsoft Build Live
プレイグラウンドでの動作確認 Microsoft Foundryでは、エージェントをデプロイする前に、プレイグラウンド機能を用いてエージェントと対話し、動作を確認することができます。
プロンプトを入力すると、以下のようにWeb IQを使用して情報を取得していることが確認できます。実運用に投入する前に、想定質問を複数パターン入力し、意図した情報源が参照されているか、パッセージの粒度は妥当かを事前検証しておくことが重要です。
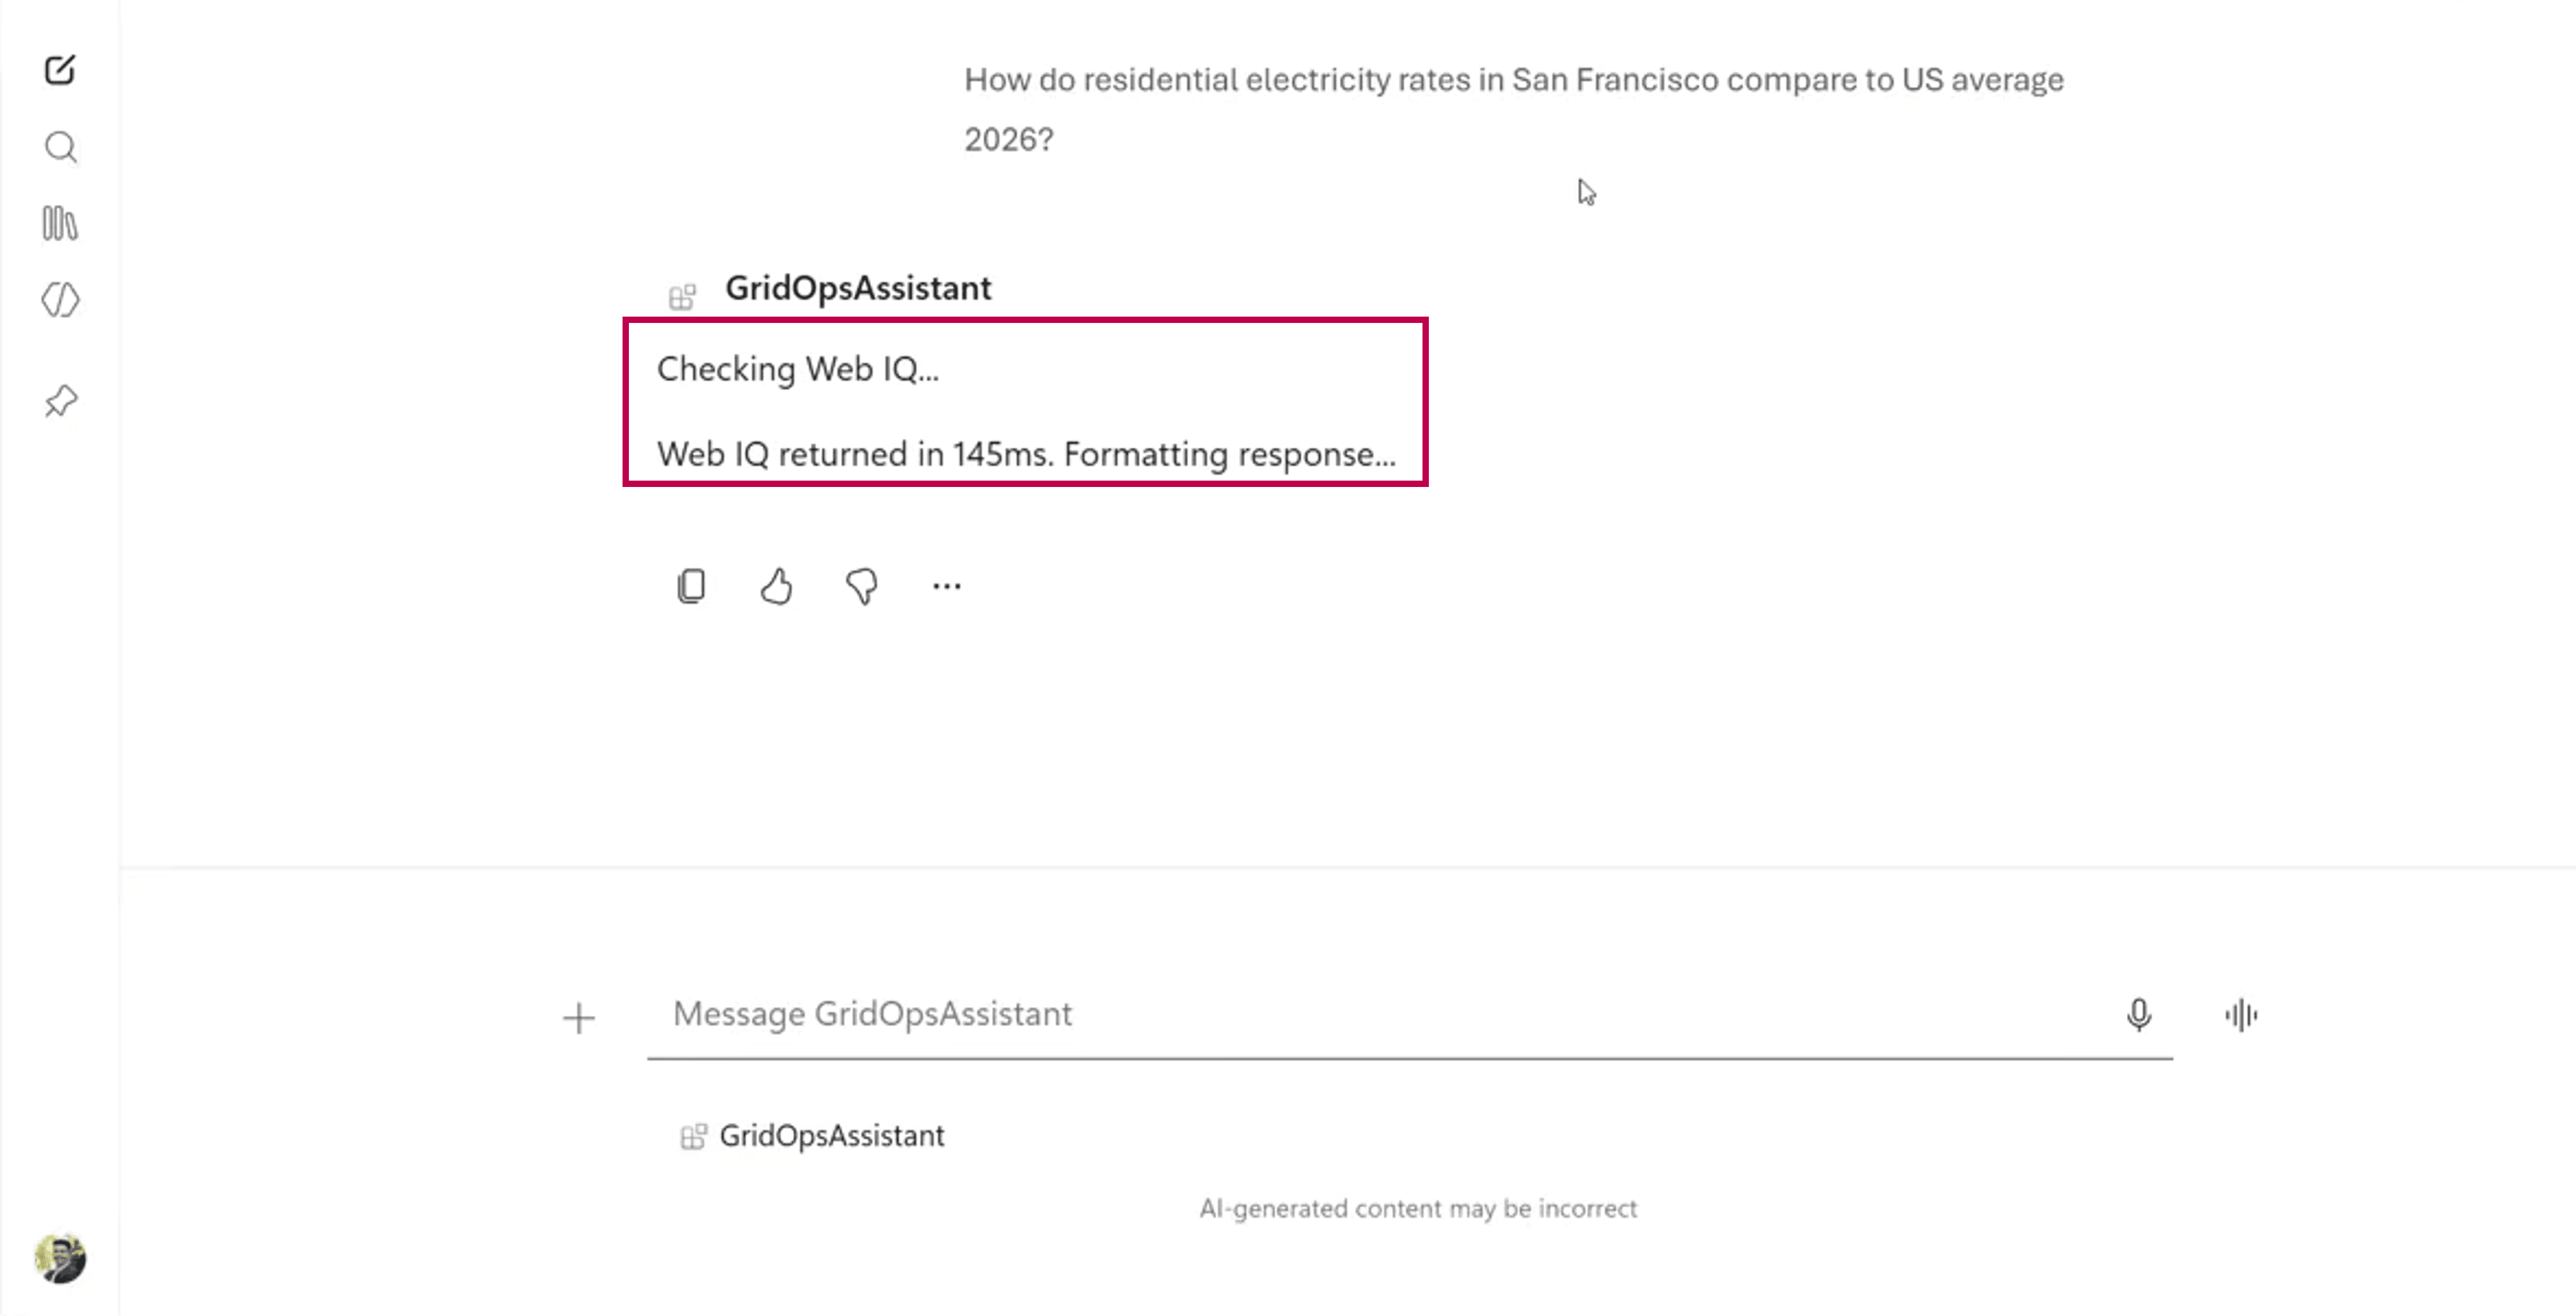
プレイグラウンドでの動作確認 引用:Microsoft Build Live
実際の応答では、以下のように、どのWebサイトを参照したかが出力されます。この情報をアプリケーション側で受け取り、ユーザー向けの回答に出典として添えることで、エージェントの回答の透明性を高めることができます。
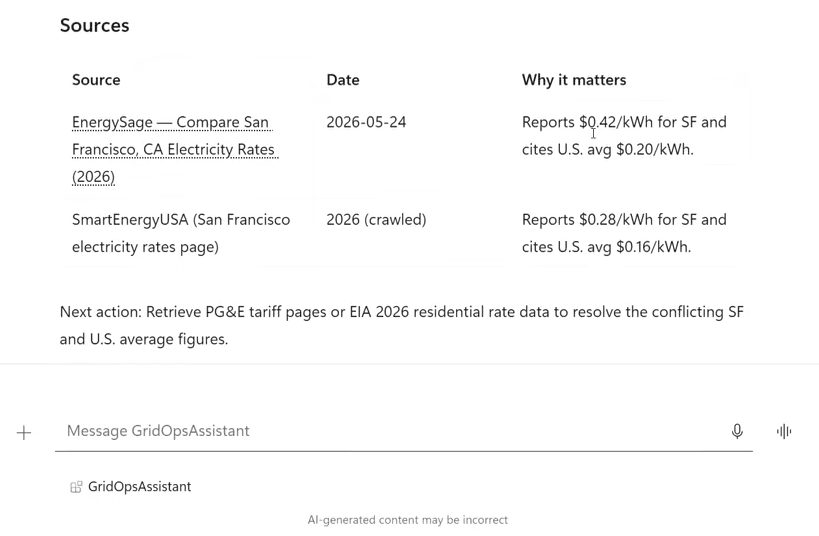
応答に含まれる情報源 引用:Microsoft Build Live
上記の手順で、AIエージェントでWeb IQを利用することができます。
Web IQを実務で活かす設計・運用のポイント
ここでは、AIエージェントの能力を引き出すうえで重要となる、Web IQの実装時・運用時に押さえておきたい設計ポイントをご説明します。
社内データと組み合わせたハイブリッド検索の設計
Web IQは単体でも高度な検索機能を提供しますが、社内データも扱う業務では、Web IQを非公開データと組み合わせた設計が有効です。Web IQで最新の外部情報を、社内システムで組織固有のデータを取得し、双方をLLMのコンテキストに投入するハイブリッド構成が現実的な設計方針の一つとなります。
Microsoftのエコシステム内には、Web IQと役割を分担する連携ソリューションが複数用意されています。組織内の会議・メール・チャットといった活動データを扱う「Work IQ」、Fabric上に集約された構造化業務データを扱う「Fabric IQ」、企業内ナレッジを一元的に扱う「Foundry IQ」があり、これらを組み合わせて複数の情報源を横断して扱うコンテキスト基盤を構築することで、自社のコンテキストに沿った精度の高いAIエージェントを構築できるようになります。
エージェント設計時には、質問の種類ごとにどのIQを優先的に呼び出すかをシステムプロンプトやツール選定ロジックで整理しておくと、応答品質の安定と不要な検索コストの削減の両面で効果を発揮します。
プロンプトを通じた抽出精度の制御
エージェントが意図した通りの検索と回答を行うためには、システムプロンプト(動作を定義する初期の指示文)の最適化が不可欠です。単に「質問に答えてください」と指示するのではなく、「出力する回答には、Web IQが取得した情報の出典URLを必ず明記してください」といった具体的なルールを定めましょう。
また、「情報の鮮度を最優先し、Web IQで取得した文章のみを用いて簡潔に回答を構成してください」と指定することで、事実関係に基づかない回答(ハルシネーション)を抑制できます。プロンプトの記述を工夫することで、根拠のトレーサビリティを高める使い方が有効です。
さらに実務では、業界用語のゆらぎや自社独自の呼称に対する検索精度を高めるため、プロンプト内に用語辞書や検索クエリの言い換え指示を含める設計も有効です。エージェントが実行する検索クエリの品質そのものを底上げすることで、Web IQ側で返される証拠オブジェクトの質を高めることができます。
トークン消費と推論コストの継続的な監視
運用フェーズにおいては、システムの利用状況とコストのバランスを適切に管理することが求められます。Web IQはパッセージ単位の抽出によってトークンを節約しますが、アクセスが集中したり、1タスクあたりの検索回数が多いエージェント設計となっていたりすると、全体としてのコストは大きく増加します。
Foundryの監視ダッシュボードやApplication Insights(Azure Monitor配下のアプリケーション監視サービス)を活用して、エージェント全体の実行状況・トークン使用量を監視します。取得件数の上限やレスポンス制御はWeb IQ側の提供するAPI仕様を確認し、コストと回答品質のバランスを定期的に見直すことが運用上の重要なコツとなります。
特にプロダクション運用に移行する段階では、月次でのコストレビューと、想定を超える消費が発生した場合のアラート設計を事前に組み込んでおくことで、限定アクセス期間中に予算超過が突発的に発生するリスクを抑えることができます。
Web IQの活用シーン
このセクションでは、Web IQがどのような業務課題の解決に役立つのか、具体的な活用シーンをご説明します。
金融および経済市場におけるリアルタイム調査
金融業界や企業の経営企画部門においては、刻々と変化する市場データや為替動向、地政学リスクを迅速に把握する必要があります。従来はアナリストが複数のニュースサイトや業界メディアを横断して情報を収集し、要点をまとめる作業に多くの時間を要していました。
Web IQを組み込んだリサーチ用エージェントは、ユーザーの指示に基づき、ウェブ上の最新の経済ニュースや企業のプレスリリースを検索して情報収集します。人間が複数のニュースサイトを横断して検索する手間を省き、要点をまとめたレポートを短時間で生成することが可能です。古い情報に依存するリスクを抑え、最新のファクトに基づく市場分析を支援します。
パッセージ単位の抽出により、レポート内に出典情報を含めた形で出力させることも可能なため、後工程でのファクトチェックや監査対応の効率化にも寄与します。
法務およびコンプライアンス部門における根拠収集
契約書の審査や法令遵守の確認を行う法務部門では、参照する情報の正確性と信頼性が重視されます。Web IQは、公開ウェブ上の関連情報を出典情報付きで取得できるように設計されており、公的機関のウェブサイトや公開されている法令情報の探索に活用できます。
エージェントが過去の判例や最新の法改正の動向を提示する際は、返却された出典情報を回答に表示するよう、アプリ側で実装・検証します。これにより、担当者は裏付け調査の時間を短縮し、より高度な法的判断の業務に専念できるようになります。
なお、法務用途でエージェントを実運用する際には、Web IQの出力そのものを最終判断の根拠とせず、必ず担当者による一次情報の確認を組み合わせる運用設計が求められます。エージェントは調査効率を高める補助として位置付け、判断責任は担当者側に残す構成が実務上の基本方針となります。
顧客サポート業務における動的なトラブルシューティング
コールセンターやヘルプデスクの業務において、顧客からの問い合わせ内容は多岐にわたり、社内マニュアルに記載されていない未知のトラブルも頻発します。サポート担当者は、その都度、公式フォーラムや製品アップデート情報を検索して対応する必要があり、対応の品質と初動速度が担当者の経験に左右されがちです。
サポート担当者を支援するエージェントにWeb IQを導入することで、自社の公式フォーラムや製品アップデートの最新情報をリアルタイムで検索させることができます。顧客を待たせることなく、ウェブ上の最新の解決策を提示できるようになるため、問題解決の効率化が期待されます。
また、顧客自身が利用するチャットボットに導入すれば、問題の自己解決を促し、有人対応へのエスカレーションを減らす効果も見込めます。社内のFAQデータとWeb IQを組み合わせることで、既知の課題は社内データで即答し、未知の問い合わせのみWeb IQで補完する構成にすると、応答速度とコストの両面で最適化を図ることができます。
Web IQを本番導入する前に確認すべき制約と留意点
ここでは、本番環境への導入を成功させるために事前に把握しておくべき、Web IQの注意点をご説明します。
プレビュー版に伴う制約事項
前述の通り、Web IQは現在限定アクセスの段階にあり、誰もが無条件に利用できるわけではありません。申請から承認までに時間を要するため、業務での本格活用を計画する場合は、承認取得までのリードタイムを見込んだプロジェクト計画を立てる必要があります。
プレビュー段階の機能は、開発におけるテストや検証を主な目的としており、通常はSLA(サービス品質保証)の対象外となります。将来的に仕様やAPIのインターフェースが変更される可能性もあるため、Microsoft公式の更新情報を継続して確認することが重要です。実運用への移行を検討する段階では、Microsoft側の一般提供(GA)に関する最新のロードマップを確認したうえで判断することが望まれます。
機密情報の送信に関するセキュリティ上の配慮
Web IQは外部のウェブ情報を検索するという性質上、クエリ(検索するための文字列)はMicrosoft側のサービスを介して処理されます。処理場所や保持条件など固有のデータ処理条件は、限定アクセス時に提示される契約・製品資料で確認する必要があります。そのうえで、社内の顧客リストや未発表の製品仕様といった機密情報を検索キーワードに含めないよう、入力内容の制御やログ監査を行うことが重要です。
具体的には、エージェントに入力されるユーザープロンプトをサニタイズする層を設けたり、機密情報が含まれる質問に対してはWeb IQを呼び出さないようツール選定ロジックで制御したりする設計が有効です。
また、エンドユーザーが利用するアプリケーションを構築する際は、RBAC(ロールベースのアクセス制御)を別途適用し、アプリケーションやユーザーがアクセスできるリソース・データの境界を明確に設定しなければなりません。
従来型の検索エンジンとの役割の明確化
混同しやすいポイントとして、Web IQは人間が使う検索エンジンの代用品ではないという点が挙げられます。通常のBing検索のように、人間が視覚的に理解しやすいレイアウトで表示したり、関連リンクのリストを提供したりすることには最適化されていません。
Web IQの出力は、あくまでAIモデルが効率的に読み込み、計算処理を行うための構造化されたデータです。人間が情報を探すための検索エンジンと、AIが推論の根拠を集めるためのバックエンドAPIというそれぞれの役割を区別し、適切な箇所にWeb IQを配置するシステム設計が不可欠です。
社内のナレッジポータルや業務システムにおける「情報を探す」機能は既存の検索エンジンやエンタープライズサーチで、AIエージェントが自律的に判断・推論するための根拠取得はWeb IQで、というレイヤー分けの整理が導入設計時の基本方針となります。
まとめ
本記事では、Web IQの概要、Grounding with Bing Searchとの違い、主な特徴、料金、Microsoft Foundryでの利用手順、実務での設計・運用のポイント、活用シーン、注意点までを解説しました。
Web IQは、AIエージェントが最新のウェブ情報を効率的に取得し、根拠付きで推論に活用するためのAIネイティブな検索API群です。セマンティック検索、DiskANN3による低遅延インデックス、パッセージ単位の証拠抽出、MCPを通じたシームレスな統合など、AIエージェント基盤にとって重要な特性を備えています。一方で、現時点では限定アクセス提供であり、実運用設計や将来的な仕様変更、機密情報の扱いには十分な配慮が必要です。
Web IQ単体でも強力な検索基盤ですが、Work IQ・Fabric IQ・Foundry IQといった他のMicrosoft IQコンポーネントと組み合わせることで、外部ウェブ情報と社内知識資産を横断的に扱うAIエージェント基盤を構築できる点が、エンタープライズ導入における最大の戦略的価値といえます。
東京エレクトロンデバイスでは、Microsoft Web IQを活用したAIエージェント基盤の設計・導入を総合的にサポートしています。Web IQの限定アクセス申請支援から、Grounding with Bing SearchとWeb IQの使い分け設計、Web IQ・Work IQ・Fabric IQ・Foundry IQを組み合わせたMicrosoft IQ 4層アーキテクチャの構築、MCP経由での既存AIエージェント・外部モデルとの統合、パッセージ抽出を活かしたプロンプト設計とトークン最適化、Foundry Monitoring・Application Insightsを活用した運用監視の整備まで、ワンストップでご支援可能です。
限定プレビュー段階から本番運用を見据えたAIエージェント基盤の構築をご検討の方は、ぜひお気軽にご相談ください。